Module 02 · Natural Language Processing & Word Embeddings
Word2VecWord2Vec
在上一视频中,我们学习了如何通过神经语言模型来获得有效的 词向量。在本视频中,我们将介绍 Word2Vec 算法,这是一种更简单、更高效的方式来学习这些词向量。让我们一起来看看吧!
Word2Vec 模型的来源与目标
本视频中的大多数思想来源于 Tomas Mikolov、Kai Chen、Greg Corrado 和 Jeff Dean 的研究。我们将介绍的是 Skip-Gram 模型,它的目标是通过构造上下文与目标词之间的映射来学习词向量。
Skip-Gram 模型的基本概念
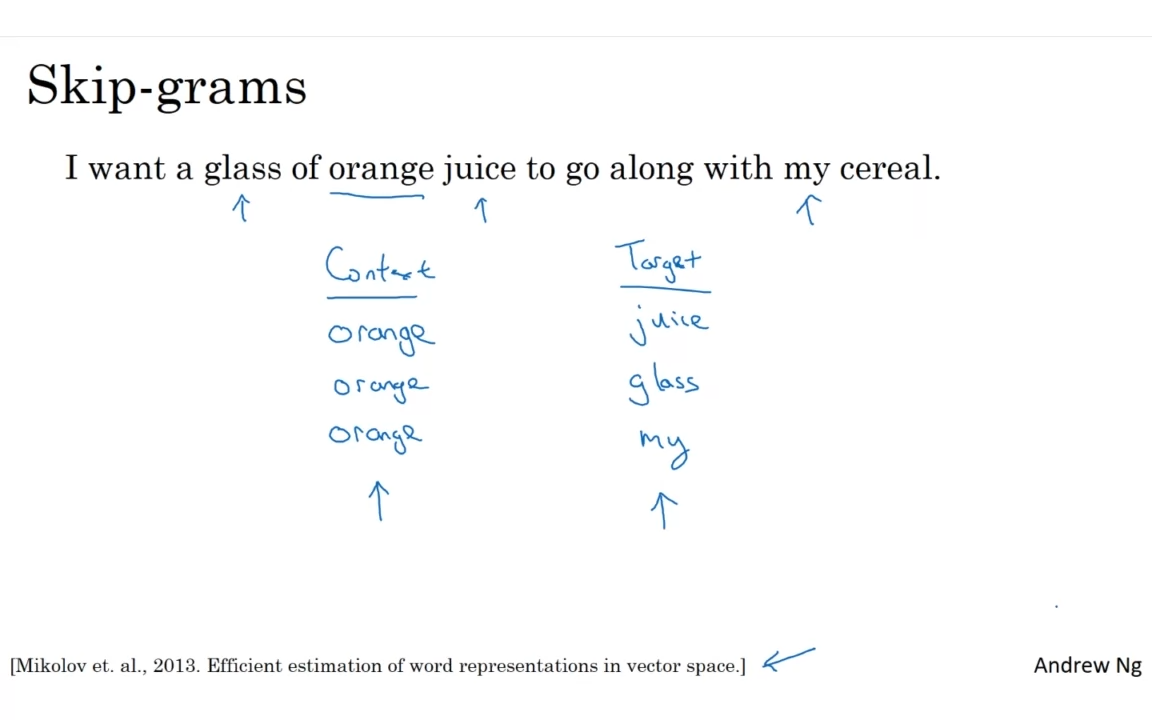
在 Skip-Gram 模型 中,我们不再仅仅使用固定的上下文窗口(如前四个单词),而是采用 随机选择上下文词 和 目标词 来创建监督学习问题。
上下文与目标词的选择
- 随机选择上下文词:
假设我们从训练集中随机选择一个单词作为上下文词,例如 "orange"。 - 在上下文词周围选择目标词:
随机选择上下文词周围的词作为目标词。例如,可能选择 "juice" 作为目标词,也可能选择 "glass" 或 "my" 等。
构建监督学习问题
- 给定一个上下文词,模型需要预测 一个在上下文词周围的词(例如,在一个 ±5 到 ±10 的窗口范围内)。
- 目标不是直接优化这个学习问题,而是通过它来学习出 好的词向量。
模型细节
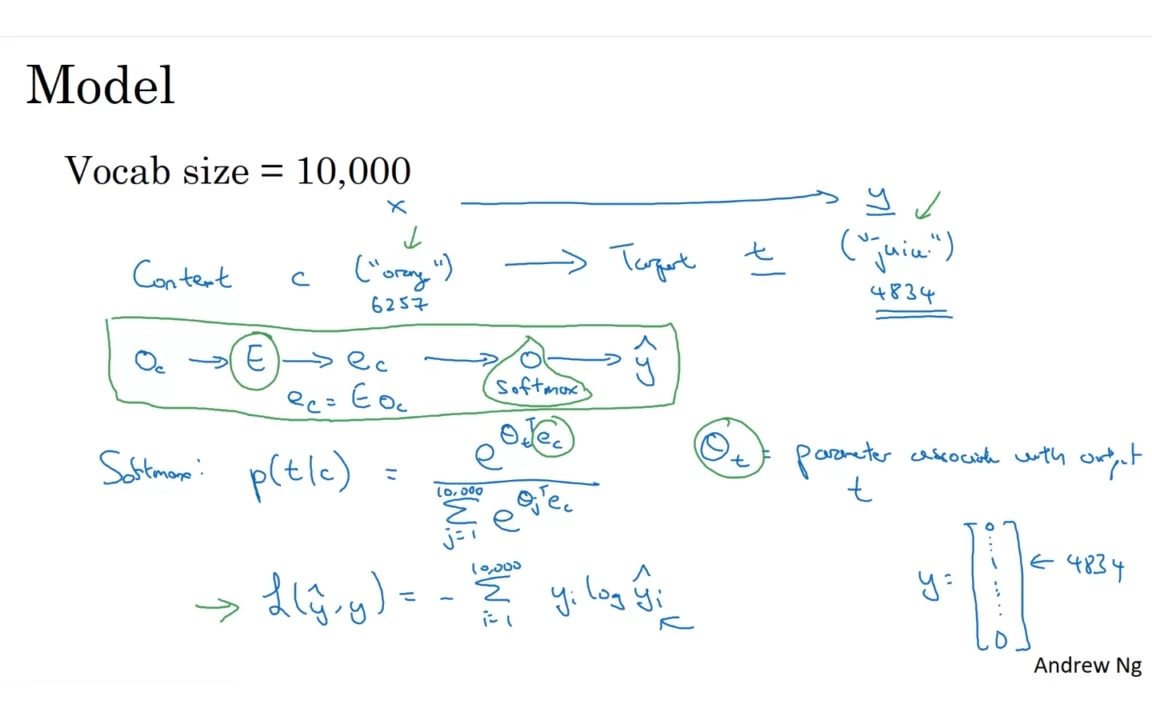
假设我们有 10,000 个词的词汇表,并且我们希望学习从 上下文词 (C) 到 目标词 (T) 的映射。以下是具体的操作过程:
- 词的表示:
- 上下文词 orange 的位置是 6257,目标词 juice 的位置是 4834,我们将其作为输入和输出进行学习。
- 使用 One-Hot 向量表示输入:
- 用 one-hot 向量 来表示上下文词 C。例如,表示 "orange" 为 O_C。
- 词嵌入矩阵 E 的计算:
- 使用 词嵌入矩阵 E 和 one-hot 向量 O_C 相乘,得到上下文词的嵌入向量 E_C。
- Softmax 输出层:
- 将 E_C 输入到一个 Softmax 单元 中,计算目标词的预测概率 ŷ。
Softmax 模型公式
- 其中,θ_t 是与目标词 t 相关的参数,V 为词汇表大小。
- 损失函数:
- 使用 负对数似然(Negative Log-Likelihood) 作为损失函数:
- 其中,y 是目标词的 one-hot 向量,ŷ 是模型的输出概率分布。
Skip-Gram 模型的总结
- Skip-Gram 模型 通过一个上下文词来预测它周围的目标词。它的关键是学习到的 词嵌入(embedding)。
- 该模型的输入是上下文词的 嵌入向量 E_C,输出是 Softmax 单元计算出的目标词的概率分布。
计算问题与解决方案
计算速度的瓶颈
- Softmax 计算的效率问题:
每次计算概率时,都需要对 10,000 个词进行求和,这在大词汇表时会变得非常慢。 - 词汇表大小的影响:
如果词汇表大小达到 100,000 或 1,000,000,每次都需要对所有词汇进行求和,计算速度会大大降低。
解决方法:分层 Softmax 分类器
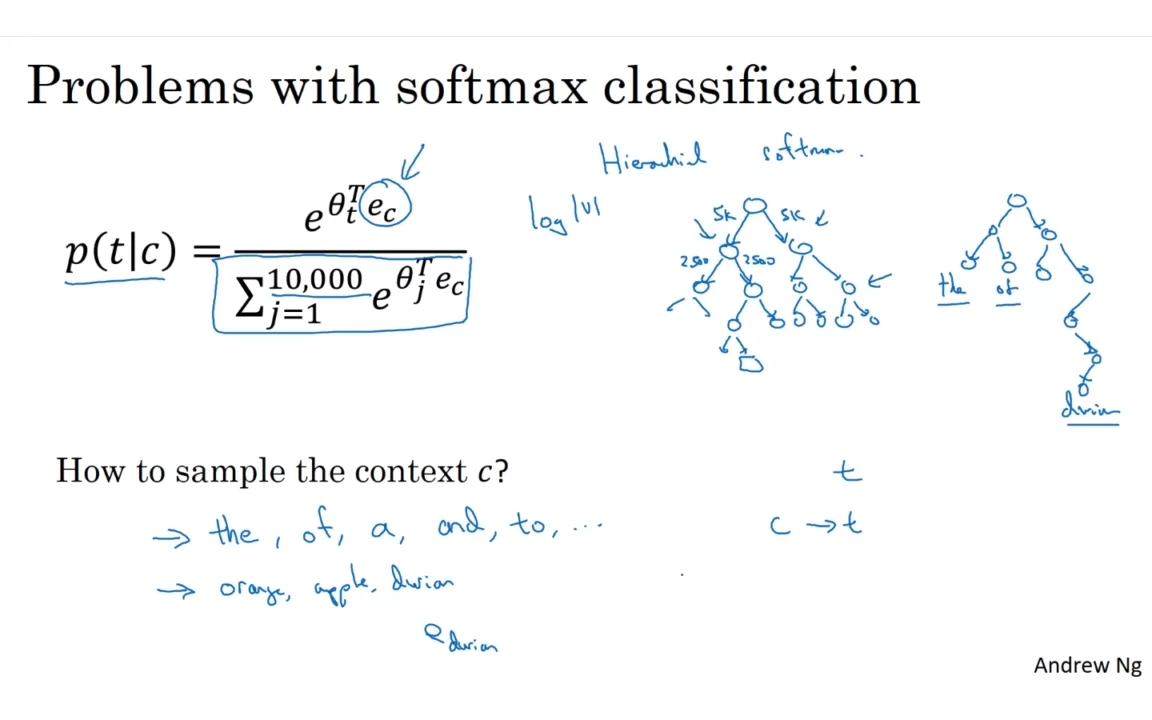
为了提高计算效率,我们可以使用 分层 Softmax(Hierarchical Softmax):
- 分层 Softmax 的工作原理:
- 假设我们有一个树形结构,每个节点表示一个二分类问题。通过该树,我们可以从上到下逐渐缩小范围,最终确定目标词。
- 树形结构的优点:
- 每次分类只需要处理词汇表的一部分,因此 分类的复杂度是对数级别,即 O(log(V))。
- 树结构的优化:
- 在实际应用中,树并不一定是完全平衡的。常见的单词(如 "the"、"of")可能位于树的上层,而较少出现的单词(如 "durian")则在树的较深层。
分层 Softmax 的优势
- 相比于线性求和,分层 Softmax 可以显著提升计算速度,特别是在大规模词汇表时。
更高效的采样方法
采样上下文词(C)的方法
- 随机均匀采样:
在最简单的情况下,我们可以均匀地随机选择上下文词,但这样会导致频繁出现的词(如 "the"、"of")在训练过程中占据主导地位,影响稀有词(如 "durian")的学习。 - 平衡采样:
为了避免频繁词的主导地位,上下文词的采样可以使用某些启发式方法来平衡常见词和不常见词的出现频率。
总结与展望
- Word2Vec 的 Skip-Gram 模型 是通过学习上下文词和目标词之间的映射来获得词向量。
- 分层 Softmax 是提高计算效率的有效手段,尤其适用于大词汇表。
- 下一视频将介绍一种 负采样(Negative Sampling) 方法,它更加简洁且有效,能够进一步提升 Softmax 分类器的计算效率。
接下来,我们将进入 负采样(Negative Sampling) 的介绍。