Module 02 · Natural Language Processing & Word Embeddings
Using Word Embeddings使用词嵌入
在上一节课中,我们学习了如何通过 特征化表示 来表示不同的单词。在这一节中,我们将探讨如何将这些表示应用到 自然语言处理(NLP) 的实际任务中。让我们通过一个实例来进行说明。
命名实体识别(Named Entity Recognition, NER)案例
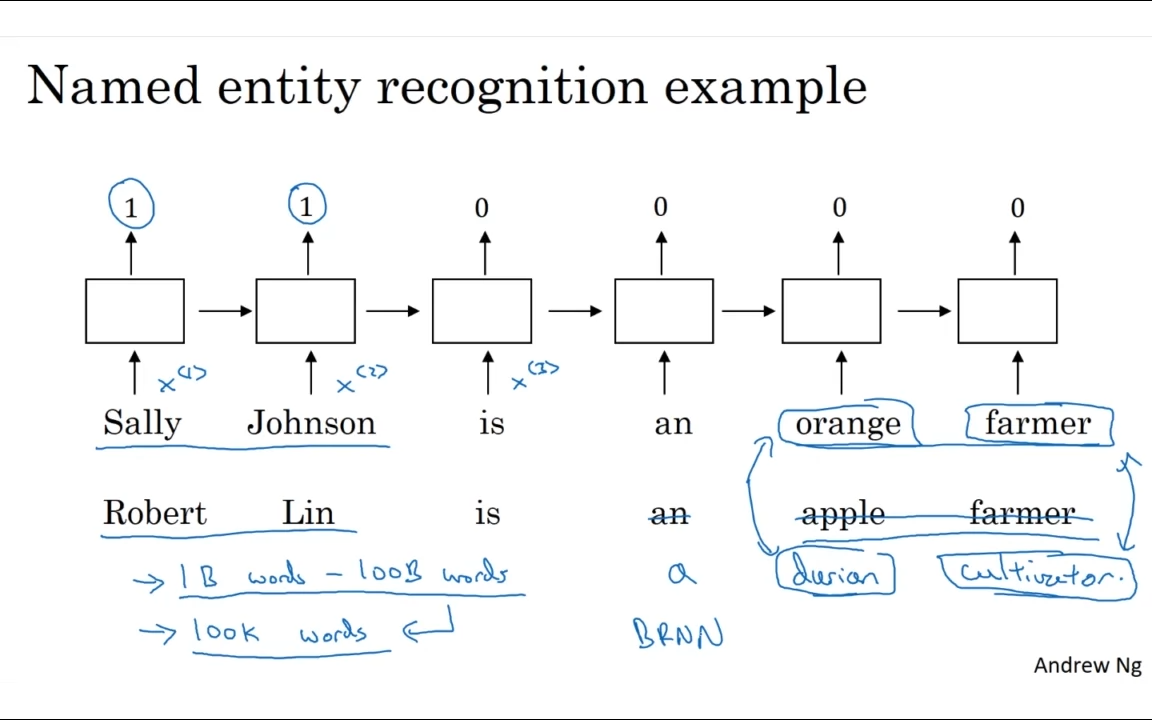
假设我们正在处理 命名实体识别任务,目的是检测句子中的人名。给定一个句子:
"Sally Johnson is an orange farmer."
我们希望识别出 "Sally Johnson" 是一个人名。为了确保 Sally Johnson 是人名,而不是公司名,我们可以利用上下文信息:例如,“orange farmer” 这一短语意味着它指的是一个人。
从一热向量到词向量的进化
之前我们使用 一热向量 来表示每个单词,但现在,我们可以使用我们在上一节课中讨论过的 词向量(embedding vectors) 来表示这些单词。经过训练的模型,若输入了以下句子:
"Robert Lin is an apple farmer."
由于 "orange" 和 "apple" 这两个词在语义上非常相似,算法能够更容易地推断出 "Robert Lin" 也是一个人名。这是因为我们通过学习 词向量,使得 "orange" 和 "apple" 在语义空间中彼此接近,从而帮助模型做出更好的泛化。
处理不常见词的挑战
假设在测试集上我们遇到一个更少见的词组:
"Robert Lin is a durian cultivator."
Durian 是一种稀有的水果,尤其在新加坡和少数几个国家很受欢迎。假设我们在训练集上从未见过 “durian” 或 “cultivator” 这些词。幸运的是,如果我们已经通过 词向量 学习到 "durian" 是一种水果,类似于 "orange",而 "cultivator" 和 "farmer" 是类似的职业词汇,那么我们仍然可以通过已有的知识,推断出 "durian cultivator" 也是指一个人。
词向量的优势
通过 大规模文本语料库(如互联网文本)进行学习,算法能够发现 "orange" 和 "durian" 是水果,"farmer" 和 "cultivator" 是类似职业。这种信息帮助模型 泛化,即使面对训练集中从未见过的词汇,也能够有效识别并做出准确判断。
迁移学习(Transfer Learning)在NLP中的应用
迁移学习步骤
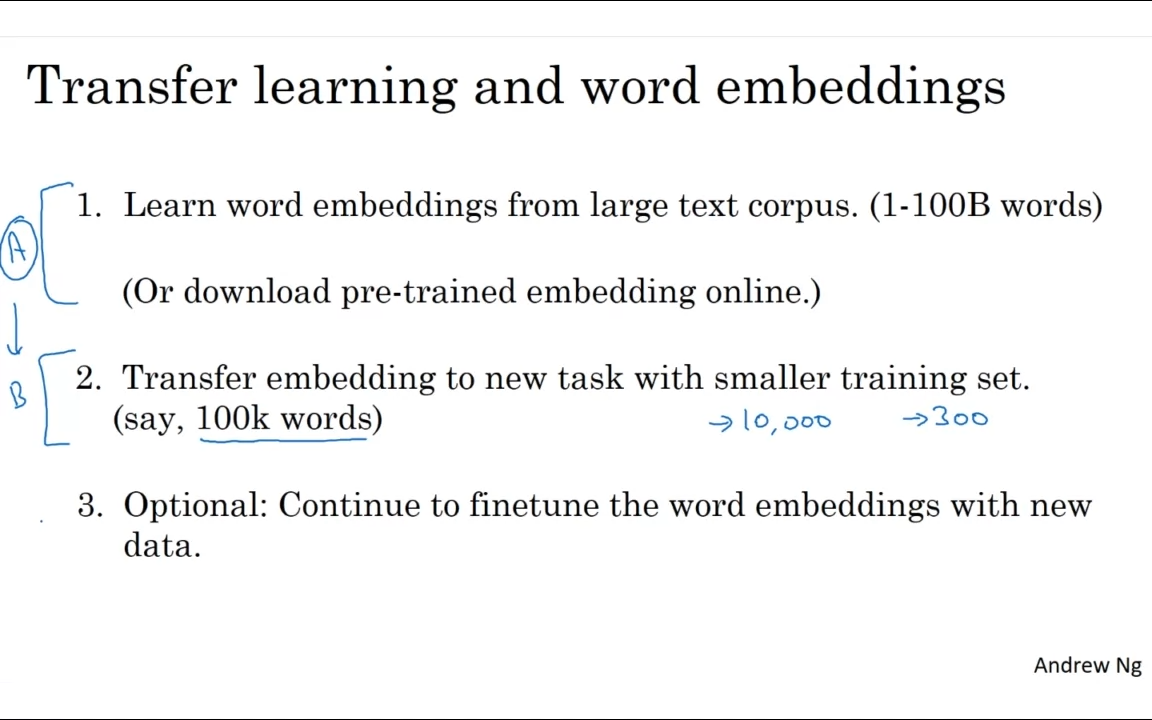
- 学习词向量:首先,我们从一个 大规模文本语料库(比如包含数十亿字的无标签文本)中学习词向量。这些语料库可以从互联网上免费下载,并通过大量的无标签数据来学习 词语的相似性。
- 转移到新任务:然后,将学习到的 词向量 应用到一个新的任务中,例如 命名实体识别(NER)。即便这个任务的标签数据集很小,模型仍然能够利用词向量中的信息做出更好的推断。
- 任务训练:通过将 300维的词向量 作为输入特征,而不是传统的 10,000维一热向量,模型在训练时能够更高效、更准确地识别新的实体。
这种方法的一个优势是,我们使用的词向量是 密集的(dense) 向量,而不是 稀疏的(sparse) 一热向量。因此,训练效率会更高,且模型能够利用更少的标签数据进行有效学习。
微调词向量(Fine-tuning)
如果 任务2 的数据集较大,可以选择 微调 词向量,即在新任务的训练过程中继续调整词向量。微调 过程通常适用于数据量较大的情况,但如果 标签数据集 很小,那么通常不需要微调。
词向量在NLP任务中的实际应用
词向量 在很多 NLP任务 中都非常有用,以下是一些典型的应用:
- 命名实体识别(NER)
- 文本摘要(Text Summarization)
- 共指消解(Co-reference Resolution)
- 句法分析(Parsing)
然而,对于某些任务,如 语言建模(Language Modeling) 和 机器翻译(Machine Translation),如果训练集数据量很大,词向量的作用就相对较小。
词向量与人脸识别中的编码的相似性
在 人脸识别 中,我们也有类似于 词向量 的概念。之前我们在卷积神经网络课程中学习过,Siamese 网络 会为每张人脸生成一个 128维的向量表示。然后通过比较这些向量,判断两张照片是否为同一个人。
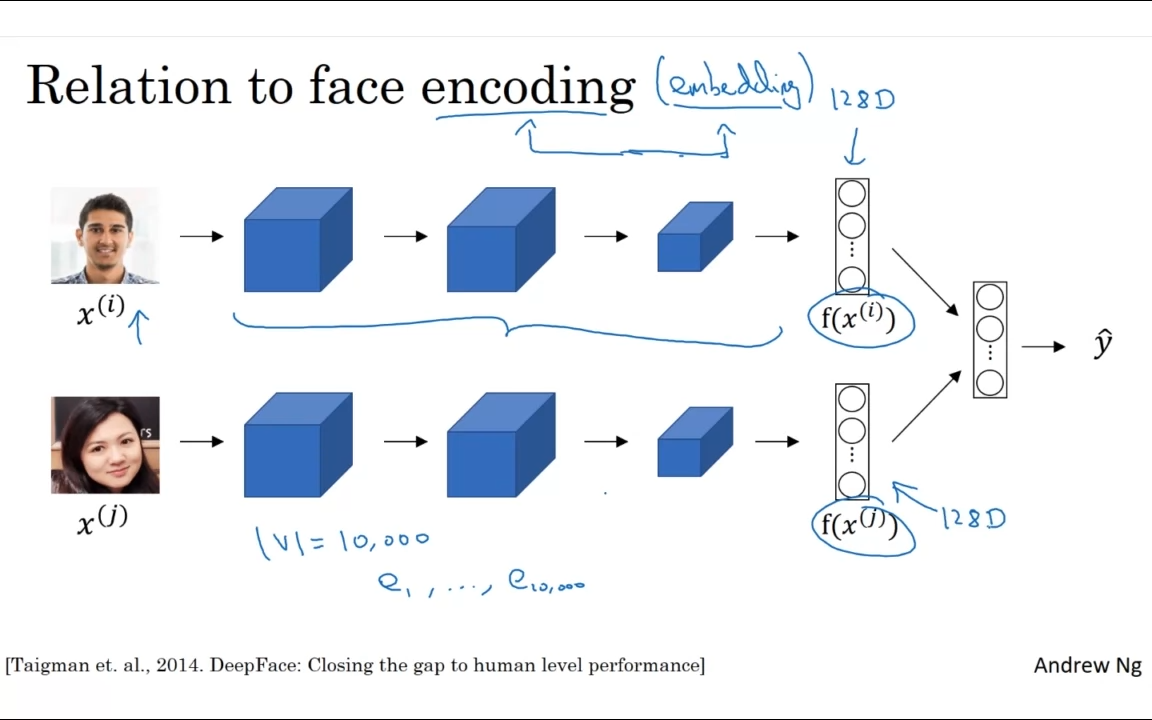
在 词向量 和 人脸识别编码 之间,有一些相似性:二者都涉及到通过一个 固定的向量表示 来捕捉对象的特征。然而,人脸识别任务是为 每个输入图像 生成新的向量,而 词向量 则是为 固定词汇表 中的每个词生成一个固定的向量表示。
总结:通过词向量实现迁移学习
在本节课中,我们学习了如何通过 词向量 实现 迁移学习,并且如何通过 替换一热向量 为 词向量 来使得算法能够更好地 泛化,从而用更少的标注数据来学习任务。我们还探讨了 迁移学习 在小规模标注数据集上的优势,尤其是在 命名实体识别(NER) 这类任务中。
接下来的视频中,我们将继续探索 词向量 的其他特性,并讨论如何使用 词向量 进行类比推理(reasoning about analogies)。让我们继续学习!🚀