Module 02 · Natural Language Processing & Word Embeddings
Negative Sampling负采样
在上一段视频中,我们学习了 Skip-Gram 模型,它如何构建一个监督学习任务,将上下文词映射到目标词,从而帮助我们学习有用的词向量。然而,这种方法的缺点在于 Softmax 目标函数 计算速度较慢。今天,我们将学习一个修改过的学习问题——负采样(Negative Sampling),它在保持与 Skip-Gram 模型相似的同时,使用了更高效的学习算法。让我们来了解一下这个算法如何工作!🧑💻
负采样的基本思想
基本概念
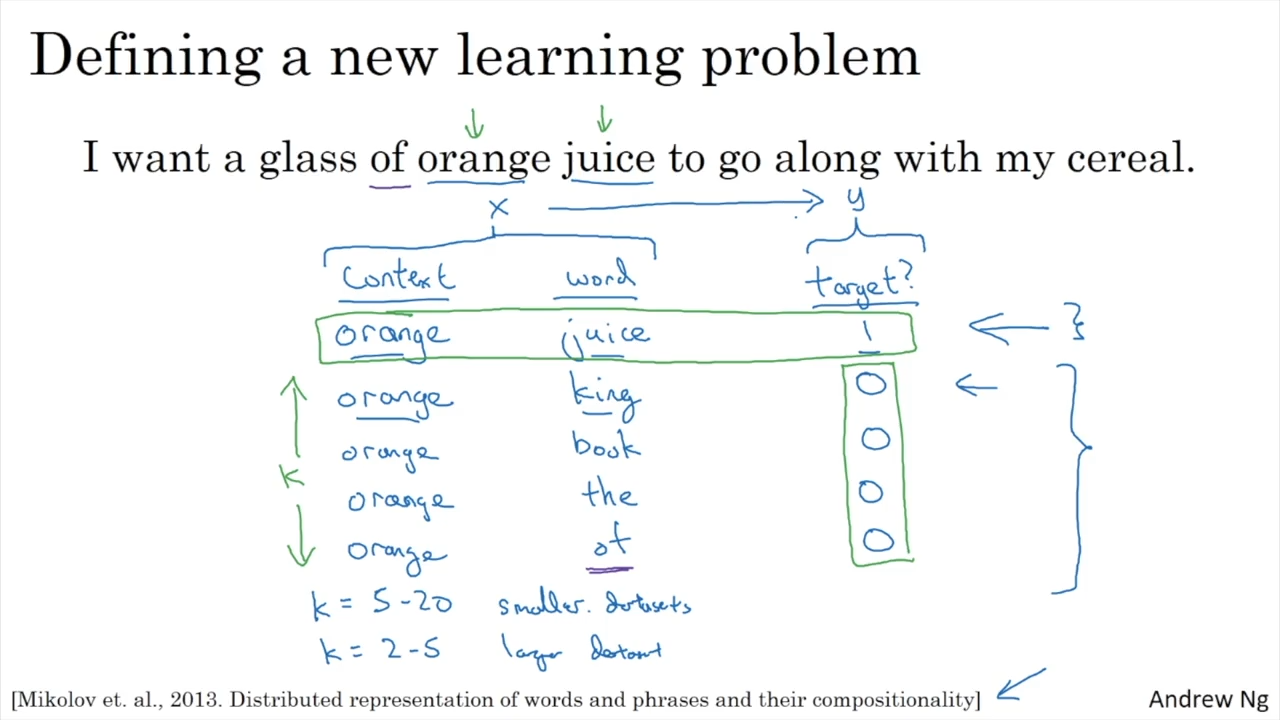
负采样的主要思想是,通过将上下文词和目标词的配对预测为一个标签为 1 的 正样本,并将其与若干个随机生成的 负样本 进行对比,从而进行有效的训练。
- 正样本:上下文词和目标词成对出现。
- 负样本:上下文词和随机选择的词(通常是与上下文词没有直接关联的词)成对出现。
如何生成训练数据
在负采样中,我们通过以下步骤生成训练集:
- 生成正样本:
- 随机选择一个上下文词(如:orange),并在一个固定窗口内(例如:±10个词)选择一个目标词(如:juice)。
- 这对词被标记为 1,表示它们是一个真实的上下文—目标词配对。
- 生成负样本:
- 对于每个正样本,我们会从词典中随机选择若干个词,并将这些随机选择的词与上下文词配对(如:orange 和 king、orange 和 book 等)。
- 这些配对被标记为 0,表示它们不是一个真实的上下文—目标词配对。
通过这种方法,我们可以生成一个训练集,其中包含了正样本和负样本。
标签说明
- 正样本:标签为 1,表示这些词对是实际在文本中一起出现的。
- 负样本:标签为 0,表示这些词对是通过随机选择生成的,不一定在文本中共现。
如何选择负样本?
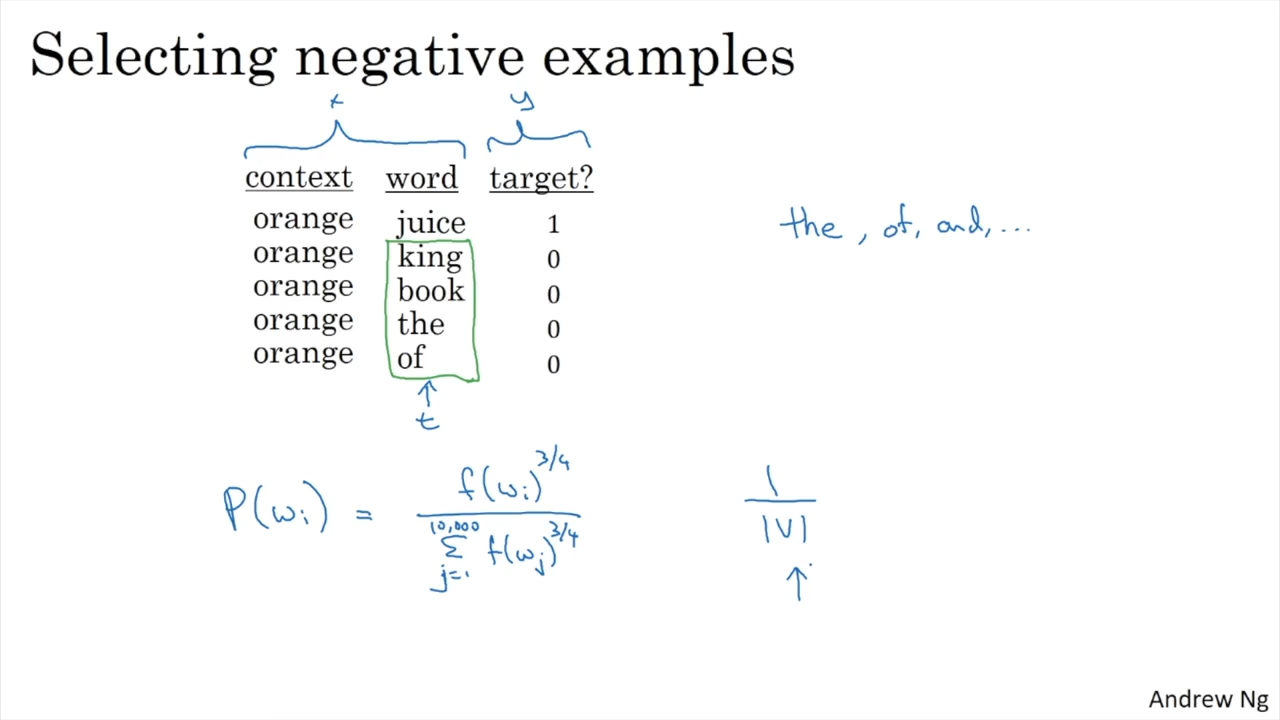
负样本的选择通常基于以下两种方式:
- 根据词频分布:直接根据词汇在语料库中的出现频率来采样负样本。
- 均匀采样:从词典中均匀随机选择词汇,通常会产生不太符合语料库实际分布的负样本。
研究表明,最佳的负样本选择方法是根据词频的幂次方采样,即根据词频的 3/4 次方 进行采样。
负采样的模型结构
模型定义
在负采样中,我们采用 逻辑回归(Logistic Regression)模型来处理每个上下文—目标词配对。其基本思路是:
- 目标:预测给定的上下文词和目标词是否为真实的词对,即 y = 1 或 y = 0。
- 模型公式:
其中:- c:上下文词
- t:目标词
- e_c:上下文词的嵌入向量
- θ_t:与目标词对应的参数向量
- sigmoid:逻辑回归中的 Sigmoid 激活函数
如何训练模型?
- 输入:每次训练时,我们会将上下文词和目标词对作为输入,进行训练。
- 输出:模型会输出一个概率值,表示给定的上下文—目标词对是否为正样本。
简化计算
与传统的 Softmax 模型不同,负采样将训练任务转化为多个 二分类 问题,每次只训练 5 个(或更多)二分类问题,而不是训练一个包含所有词汇的多分类问题。这显著提高了训练效率。
计算效率
- Softmax 模型:每次计算时需要对所有词汇进行求和,计算复杂度为 O(V),其中 V 是词汇表大小。
- 负采样:每次训练只涉及 k+1 个二分类问题(其中 k 是负样本数),计算复杂度大大降低,提升了训练速度。
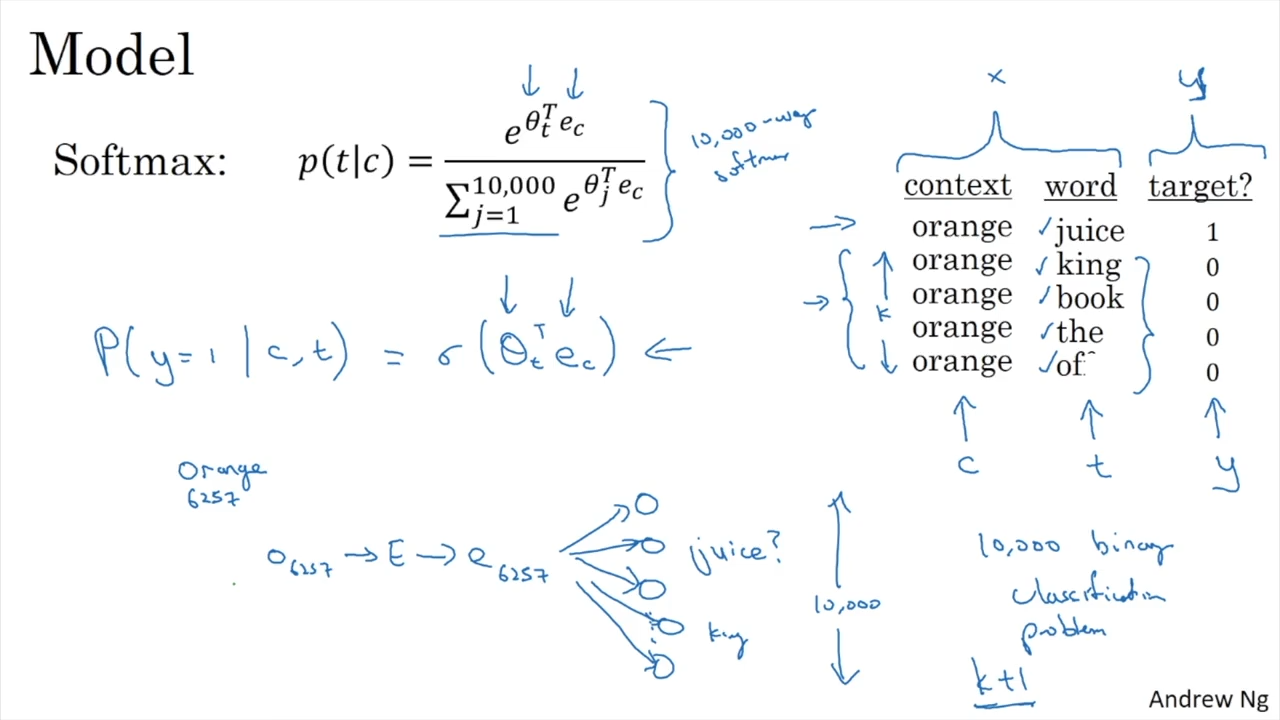
负采样的优势
- 高效性:通过将 Softmax 转换为多个简单的二分类任务,负采样显著降低了计算开销。
- 灵活性:负采样的负样本选择方法可以灵活调整,可以根据数据集的规模来优化。
- 扩展性:对于大规模数据集,负采样特别有效,因为它避免了对所有词汇进行全局求和的低效操作。
负采样的实施步骤
- 选择上下文词和目标词。
- 生成正样本:通过上下文词和目标词配对。
- 生成负样本:从词典中随机选择负样本,并标记为 0。
- 训练模型:使用逻辑回归模型进行二分类训练。
选择参数 k
在选择负样本的数量时,一般建议:
- 对于 小数据集,可以选择 k = 5-20。
- 对于 大数据集,可以选择较小的 k = 2-5。
总结
负采样通过将传统的 Softmax 转换为多个 二分类 问题,大大提升了计算效率。通过这种方法,我们可以高效地学习到良好的词向量。负采样的核心优势是计算速度快,能够处理大规模数据集,且能够通过合理选择负样本提高模型的表达能力。
在接下来的视频中,我们将介绍另一种词向量学习算法——GloVe 算法,它比目前的方法更加简洁易懂,且效果非常优秀。🎥
希望大家通过负采样能更好地理解如何高效学习词向量!