Module 03 · Sequence Models & Attention Mechanism
Refinements to Beam Search束搜索的改进
在上一期视频中,我们介绍了 基本搜索算法,本期视频将展示如何通过一些小的调整,使 束搜索算法 更加高效,从而得到更好的翻译结果。
长度归一化:提升束搜索的有效性
长度归一化(Length Normalization) 是束搜索中的一个小变化,然而它能显著提升搜索结果的质量。下面我们来详细了解这一优化方法。
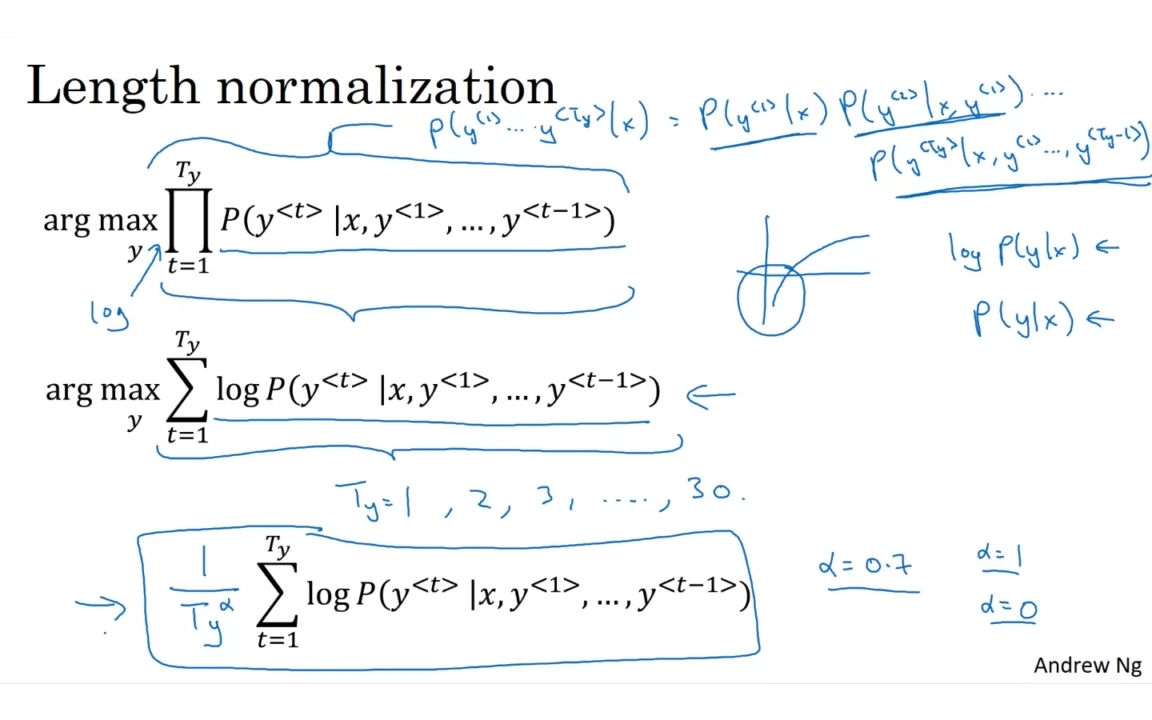
1. 目标函数与对数变换
我们之前提到过束搜索的目标是最大化概率 ,其中:
- ......
这些概率值通常都小于 1,且连续相乘可能会得到非常小的数值,最终导致 数值下溢(underflow),即计算机的浮点数无法准确存储这些小数值。
使用对数函数避免数值下溢
- 为了避免这种情况,通常我们会对这些概率取对数:
- 这样一来,乘法变成了加法,数值更加稳定,减少了 数值舍入误差。
通过对数变换,算法变得更 数值稳定,并且可以有效避免数值下溢问题。因为对数函数是严格单调递增的,最大化 对数概率 相当于最大化原始的 概率。
2. 长句子的问题:短句偏好
但是,使用这种目标函数时,有一个 不理想的效果:对于较长的句子,由于要乘以更多的概率(每个概率都小于1),会导致整体概率较低。
- 长句子的概率较低,因为我们在计算时涉及更多的概率值,且这些概率值通常小于1,乘积会变得非常小。
- 这会导致模型偏好生成 较短的句子,因为短句子的 概率较高,计算时涉及的乘法项较少。
3. 长度归一化的优化
为了消除 短句偏好 的问题,我们引入了 长度归一化。
长度归一化公式
- 在传统目标函数中,句子的概率会随着句子长度的增加而逐渐减小。
- 为了纠正这一点,我们可以 归一化 句子的长度,即:
其中 是句子的长度, 是一个超参数,通常设定为 0.7。
归一化的意义
- :完全按照句子长度进行归一化。
- :不进行归一化,完全依赖于概率。
- :这是一种 软归一化,将句子长度的影响降到最低。
通过这种方式,长度较长的句子将不会因为概率值过低而受到过大的惩罚,从而生成更自然、更符合实际语境的长句。
如何选择适合的束宽度(Beam Width)
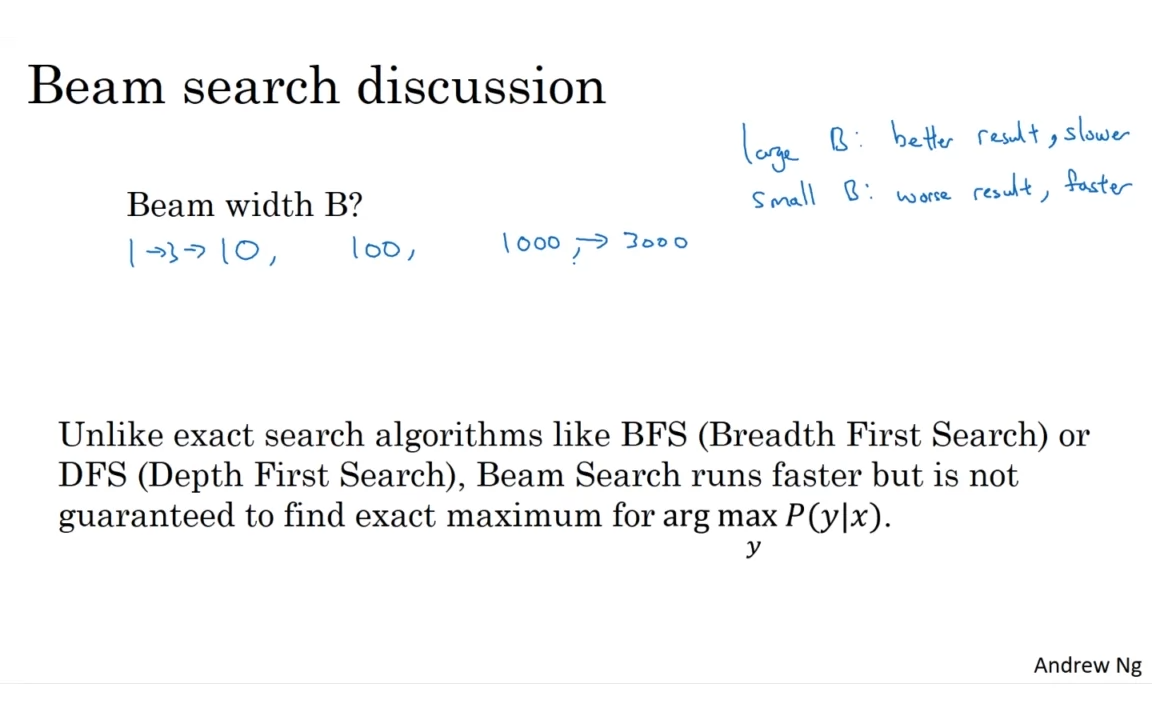
束宽度的选择对结果的影响
- 束宽度大:会考虑更多的候选翻译,从而可能得到更好的结果。然而,这会导致 计算速度变慢,内存需求增加,并且 计算成本较高。
- 束宽度小:考虑较少的候选翻译,计算速度更快,内存需求更低,但翻译结果可能不如束宽度大的情况。
束宽度选择的实践经验
- 在生产环境中,常见的束宽度在 10 左右。
- 在研究系统中,为了追求 最佳的翻译效果,束宽度有时会设置为 1000 或 3000,但这对于大多数应用来说,效果的提升已经趋于 递减。
束宽度与性能的平衡
- 束宽度为 3:这是我们在例子中使用的设置,适用于大多数实际应用。
- 束宽度为 100:在某些高性能需求的生产环境中,适用于需要尽可能多考虑翻译选项的情况。
- 束宽度为 1000 或更大:一般用于 研究系统,目的是尽可能优化结果,常见于研究论文的发布场景。
束搜索与经典搜索算法的比较
如果你曾学习过 广度优先搜索(BFS) 或 深度优先搜索(DFS),可以将 束搜索 与这两种算法做一个对比:
- 束搜索 不是精确搜索算法,它比广度优先和深度优先搜索要 快速,但不保证能够找到最优解(即 arg max)。
- 广度优先(BFS) 和 深度优先(DFS) 都是 精确搜索算法,而束搜索则 更高效,但 没有精确的最优保证。
如何评估和选择最佳的束宽度
- 在运行 束搜索 时,考虑不同长度的翻译句子,例如:长度为 1、2、3、4 等。
- 对每个候选翻译句子计算其 归一化的对数概率。
- 最终,选择 最大化归一化对数概率的句子 作为最终翻译结果。
总结与实践
通过 长度归一化 和 优化束宽度,我们可以有效提升 束搜索算法 的性能。在实际应用中,根据需求选择合适的 束宽度 和 归一化策略,将帮助你在实际任务中获得更好的翻译效果。
在本周的编程练习中,你将有机会亲自体验这些优化技巧,进一步加深对束搜索的理解与应用。
📅 下一步: 在下一个视频中,我们将讨论如何进行 错误分析,以便进一步优化束搜索的表现,并回答一些关于束宽度选择的常见问题。