Module 02 · Natural Language Processing & Word Embeddings
Embedding Matrix嵌入矩阵
我们开始正式化 学习词向量 的问题。在实现学习词向量的算法时,我们最终会学习到一个 嵌入矩阵(embedding matrix)。让我们来看一下这意味着什么。
构建嵌入矩阵
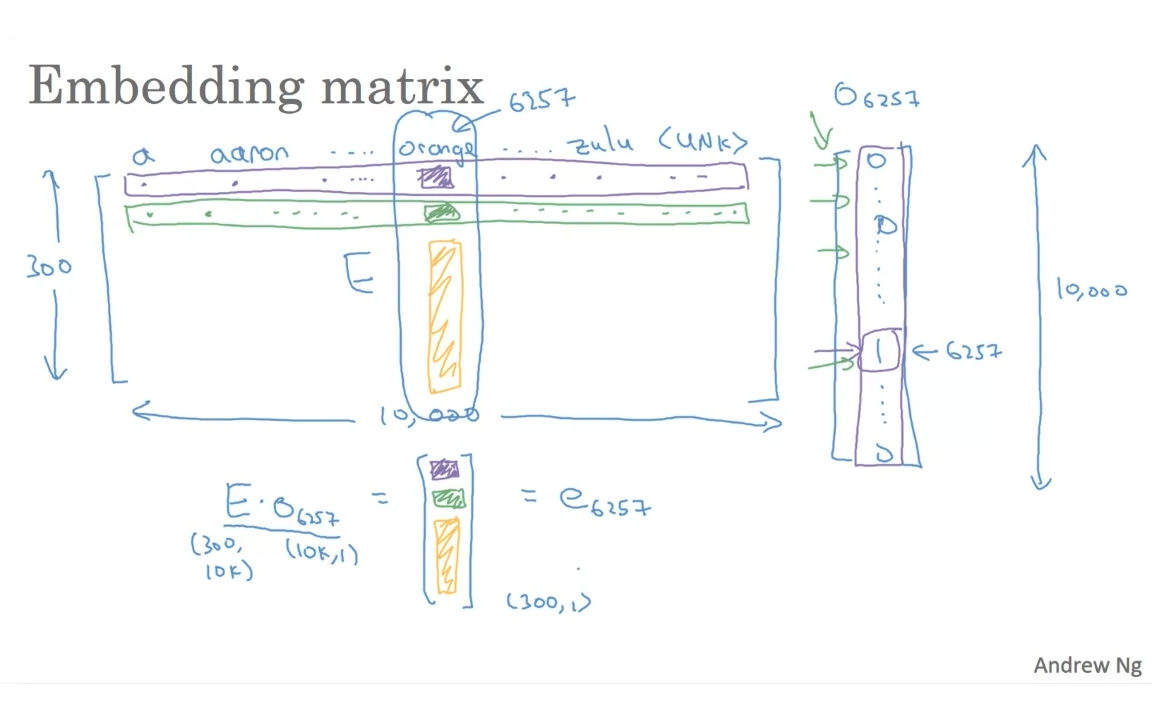
假设我们有一个 10,000个单词的词汇表(vocabulary),词汇表中可能包括单词 A, Aaron, Orange, Zulu,以及一个 未知单词(unknown word) 作为标记。我们的目标是学习一个 嵌入矩阵(E),它的尺寸是 300维 × 10,000维,如果我们的词汇表包含 10,000个单词,或者 10,001个单词(包含未知单词标记)。这个矩阵的列将是每个单词的 嵌入向量(embedding vector)。
嵌入矩阵的定义与运作
- 词汇表中的单词 "Orange" 是我们词汇表中的第 6257个单词,因此我们可以用 one-hot 向量 来表示它。
One-Hot 向量示例
如果 Orange 是词汇表中的第 6257个单词,那么它的 one-hot 向量 将是一个 10,000维的向量,其中第 6257 个位置为 1,其他位置为 0。
嵌入矩阵与 One-Hot 向量的乘法操作
- 假设我们的 嵌入矩阵(E) 是一个 300维 × 10,000维 的矩阵。
- One-hot 向量 的尺寸是 10,000维 × 1维。
当我们将嵌入矩阵 E 与 one-hot 向量 相乘时,结果将是一个 300维 × 1维 的向量。这个向量就是 Orange 对应的 嵌入向量。
运算过程
- 矩阵与向量相乘:
- 我们用 E 乘以 one-hot 向量,得到一个 300维的向量。
- 如何计算该向量的第一个元素?
- 计算这个 300维向量的第一个元素 时,我们实际上是将 E 的 第一行 与 one-hot 向量 相乘。由于 one-hot 向量 只有一个位置是 1(即 6257位置),其他位置全为 0,因此只有 E 的第6257列 会参与运算,其他列的结果会是 0。
- 换句话说,E × one-hot 向量 选择了 E 的第6257列,该列即为 Orange 对应的 300维嵌入向量。
嵌入矩阵与 one-hot 向量的乘积
通过这个过程,E × one-hot 向量 选出了一个 300维的向量,该向量对应于词汇表中 Orange 这个单词。
我们可以用 E₆₂₅₇ 来表示这个 300维 × 1维的向量,它就是单词 Orange 的 嵌入向量。
总结
- 嵌入矩阵(E) 是一个 300维 × 10,000维 的矩阵,其中每列代表词汇表中每个单词的 300维嵌入向量。
- One-hot 向量 用来定位每个单词在词汇表中的位置,并通过与 嵌入矩阵 相乘来提取该单词的嵌入向量。
- 最终,我们通过这种方式从 嵌入矩阵 中选出了单词的 300维向量表示。
通过这种方法,我们就可以学习到一个良好的词向量嵌入,进而为后续的自然语言处理任务提供基础。