Module 03 · Sequence Models & Attention Mechanism
Attention Model Intuition注意力模型直观理解
在本周的大部分时间里,您一直在使用编码器-解码器架构进行机器翻译。在这个架构中,一个RNN(循环神经网络)读取句子,另一个则生成翻译句子。而Attention模型(注意力模型)对这个架构做出了重要的改进,使得机器翻译的效果大大提升。Attention机制被认为是深度学习领域最具影响力的想法之一,今天我们将简要介绍其工作原理。
传统的编码器-解码器架构问题
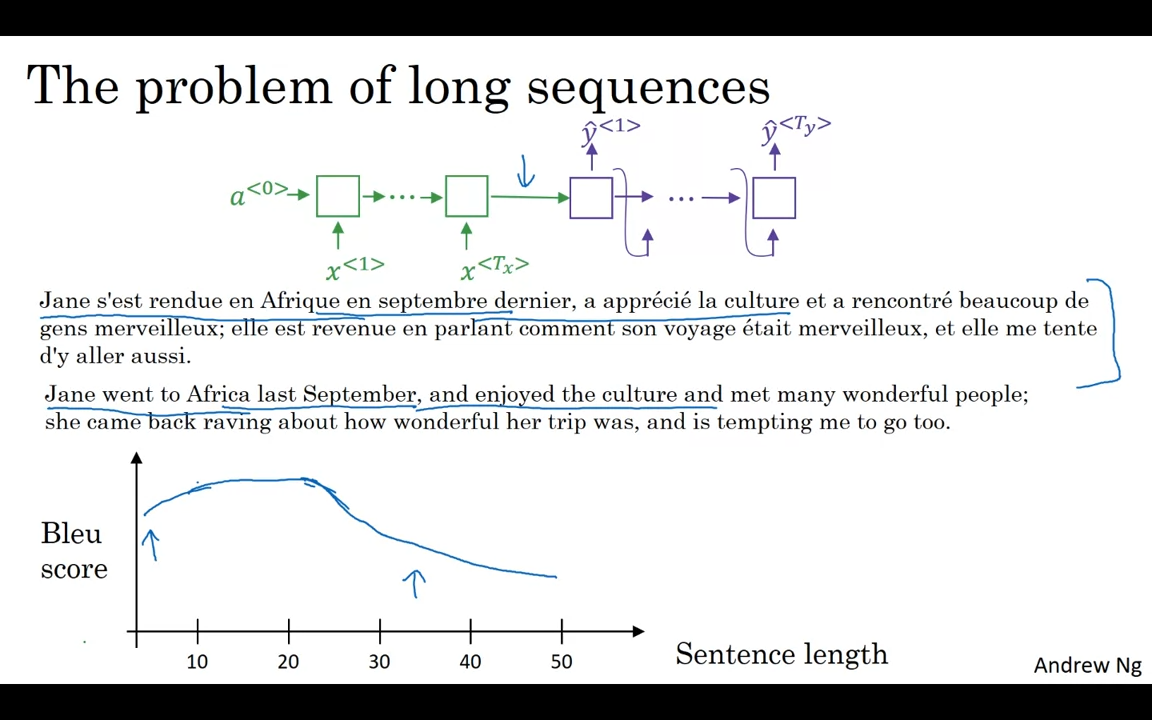
假设我们有一个长法语句子:
“Jane went to Africa last September and enjoyed the culture and met many wonderful people; she came back raving about how wonderful her trip was, and is tempting me to go too.”
在传统的编码器-解码器架构中,绿色的编码器网络会先“读取”整个句子并将其存储在激活值中。然后,紫色的解码器网络会根据这些信息生成对应的英文翻译。
然而,问题在于,人类翻译者并不会一次性读完整个句子然后开始翻译。他们的做法是:逐部分阅读句子,逐步生成翻译。例如,看到句子的第一部分时,可能就翻译出一部分,然后再看后面的部分,逐渐生成更多内容。
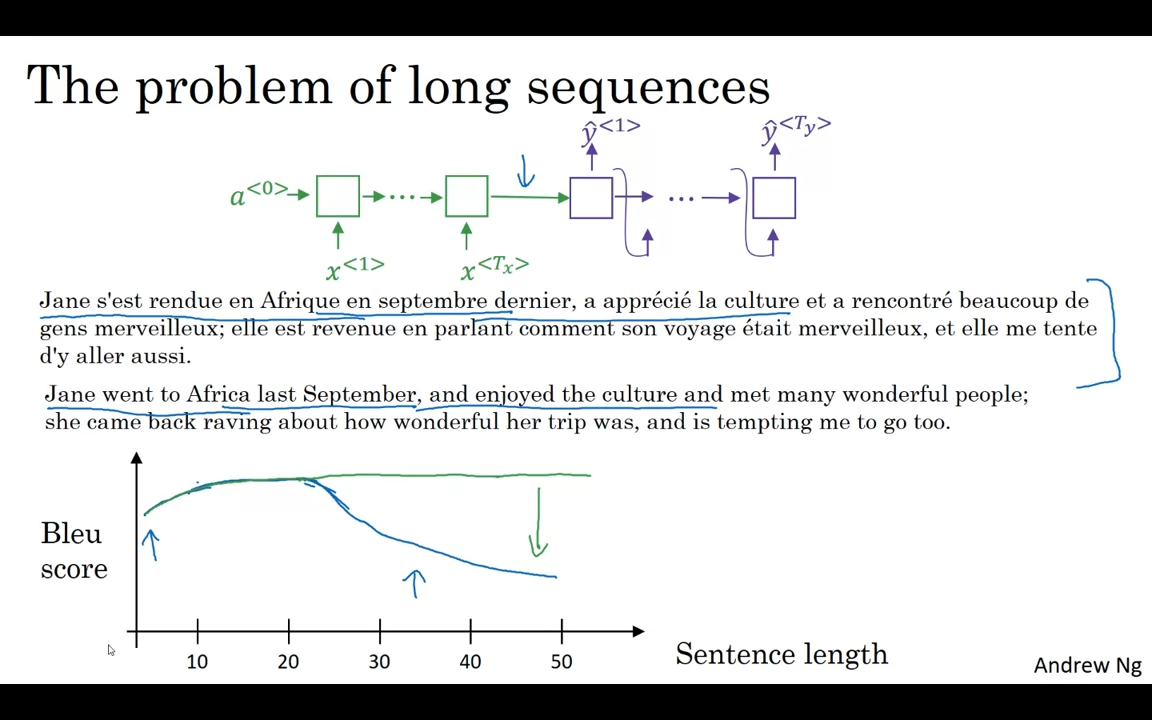
而对于机器翻译系统,当句子较短时,编码器-解码器架构能取得不错的效果,但对于超过30或40个单词的长句子,性能就会下降。具体来说,BLEU得分会随句子的增加而下降。这是因为神经网络很难记住整个长句子。
Attention模型的引入
在Attention模型中,机器翻译系统的工作方式更接近人类翻译的方式:逐步处理句子的每一部分。在这种架构下,神经网络可以避免在处理长句子时的性能下降,使得翻译效果更稳定。
我们将在下一视频中详细介绍Attention模型的细节,但首先,让我们了解一下其基本的直觉原理。
Attention模型的工作原理
Attention模型最初由Dimitri Bahdanau、KyungHyun Cho、Yoshua Bengio等人提出,虽然它最初是为机器翻译设计的,但后来它被广泛应用于其他领域。
示例:法语句子的翻译
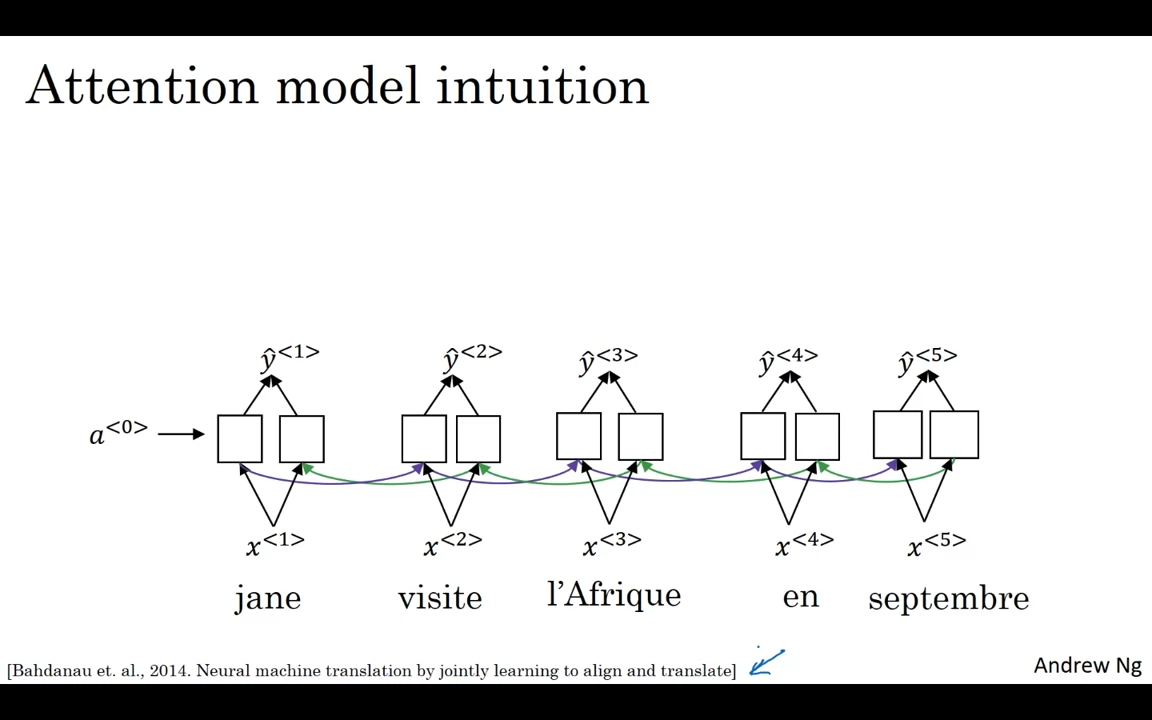
假设我们有一句简单的法语句子:
“Jane visite l'Afrique en Septembre”
(简·九月去了非洲)
在这个示例中,我们使用一个双向RNN来为每个输入词计算特征。通过双向RNN,我们能够为句子中的每个位置(如:Jane、visite、l'Afrique等)计算出丰富的特征信息,而这些特征不仅仅与该词相关,还会涉及其前后的上下文信息。
生成英文翻译
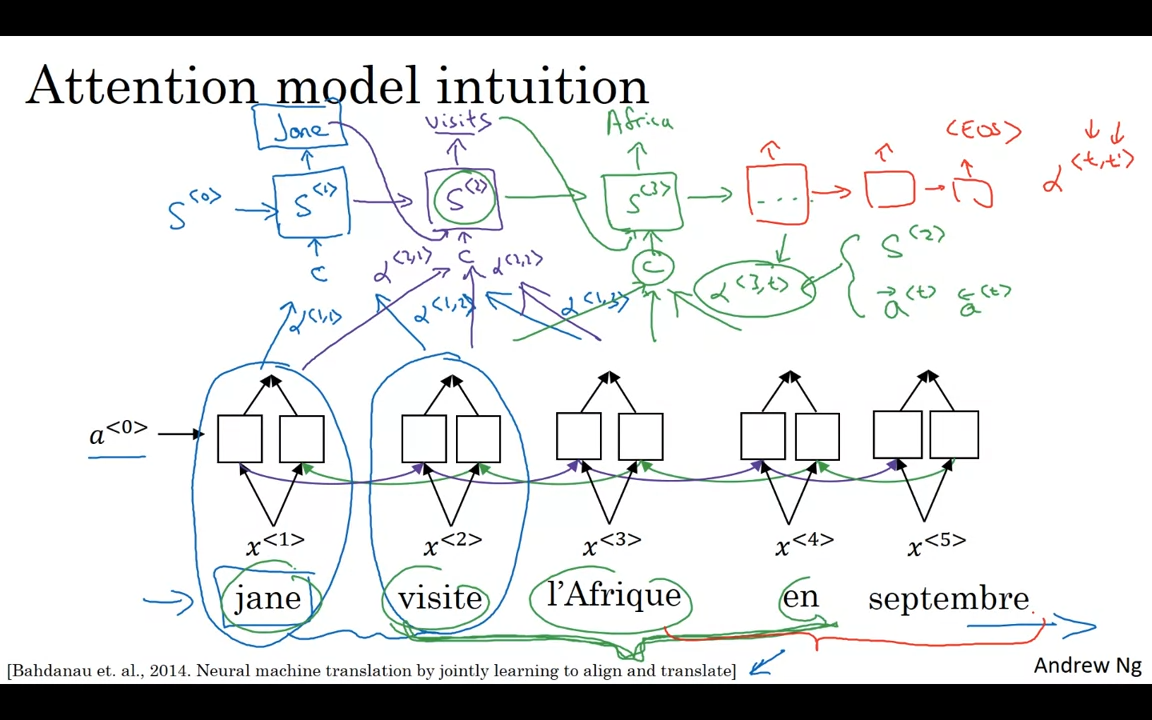
接下来,使用另一个RNN来生成英文翻译。假设我们用不同的符号S表示解码器中的隐藏状态。在生成英文翻译时,我们首先会生成词“Jane”。
**问题:**当我们试图生成第一个英文单词(“Jane”)时,应该关注法语输入句子的哪一部分?
显然,我们应该主要关注句子中的第一个单词“Jane”,而不需要关注句子的其他部分。Attention模型就是用来解决这个问题的,它会计算出一组Attention权重(α)。例如,生成第一个单词时,Attention权重α₁₁表示在生成“Jane”时,我们应该关注法语句子的第一个词“Jane”。类似地,其他的Attention权重如α₁₂、α₁₃等会分别表示我们在生成英文翻译的过程中,需要关注法语输入句子中其他位置的程度。
注意力权重的计算
在生成第一个单词时,我们会根据各个权重计算“上下文”C,这个上下文就是输入到RNN单元中的信息。
随着生成翻译的继续,解码器会逐步更新其隐藏状态(S₁、S₂、S₃等),并相应地调整Attention权重。
- 第二步:我们生成第二个单词“visits”,此时的Attention权重将告诉我们生成这个单词时需要关注法语输入句子的哪些部分。
- α₂₁:关注法语句子中的“Jane”
- α₂₂:关注“visite”
- α₂₃:关注“l'Afrique”
- ...
- 第三步:生成第三个单词时,我们会计算新的上下文C₃,Attention权重α₃₁、α₃₂等将告诉我们应该关注法语句子的哪些词。
Attention模型的关键直觉
- 每一步生成英文翻译时,模型会计算出一组Attention权重,这些权重决定了在生成特定英文单词时,应该关注法语句子中的哪些部分。
- Attention权重会随着翻译过程的推进逐步变化,使得每一步的生成都只依赖于一个局部的上下文,而不是整个句子。这种方法使得翻译更具灵活性,尤其适用于长句子的翻译。
在下一视频中,我们将深入探讨如何具体计算这些Attention权重,并进一步阐述Attention模型的实现细节。
总结
Attention机制的引入,使得神经网络能够“聚焦”于输入句子的相关部分,而非试图记住整个句子。这种方法不仅改善了机器翻译的效果,还为许多其他自然语言处理任务提供了帮助。
关键点回顾:
- Attention模型通过计算Attention权重,帮助解码器在生成翻译时只关注输入句子的局部信息。
- 这种方法克服了传统编码器-解码器架构在处理长句子时的局限性。
- Attention模型已经被广泛应用于包括机器翻译、文本生成、语音识别等多个领域。
✨ 下次我们将详细介绍如何计算Attention权重及其在实际应用中的实现。 ✨