Module 01 · Recurrent Neural Networks
Long Short Term Memory (LSTM)长短期记忆网络
在上一篇视频中,我们学习了 GRU(门控循环单元),以及它如何帮助我们捕获序列中的长期依赖。今天,我们将讨论 LSTM(长短期记忆网络),它比GRU更强大,能够更有效地解决长期依赖问题。让我们一起来了解一下!
LSTM的原理及优势
GRU与LSTM的比较
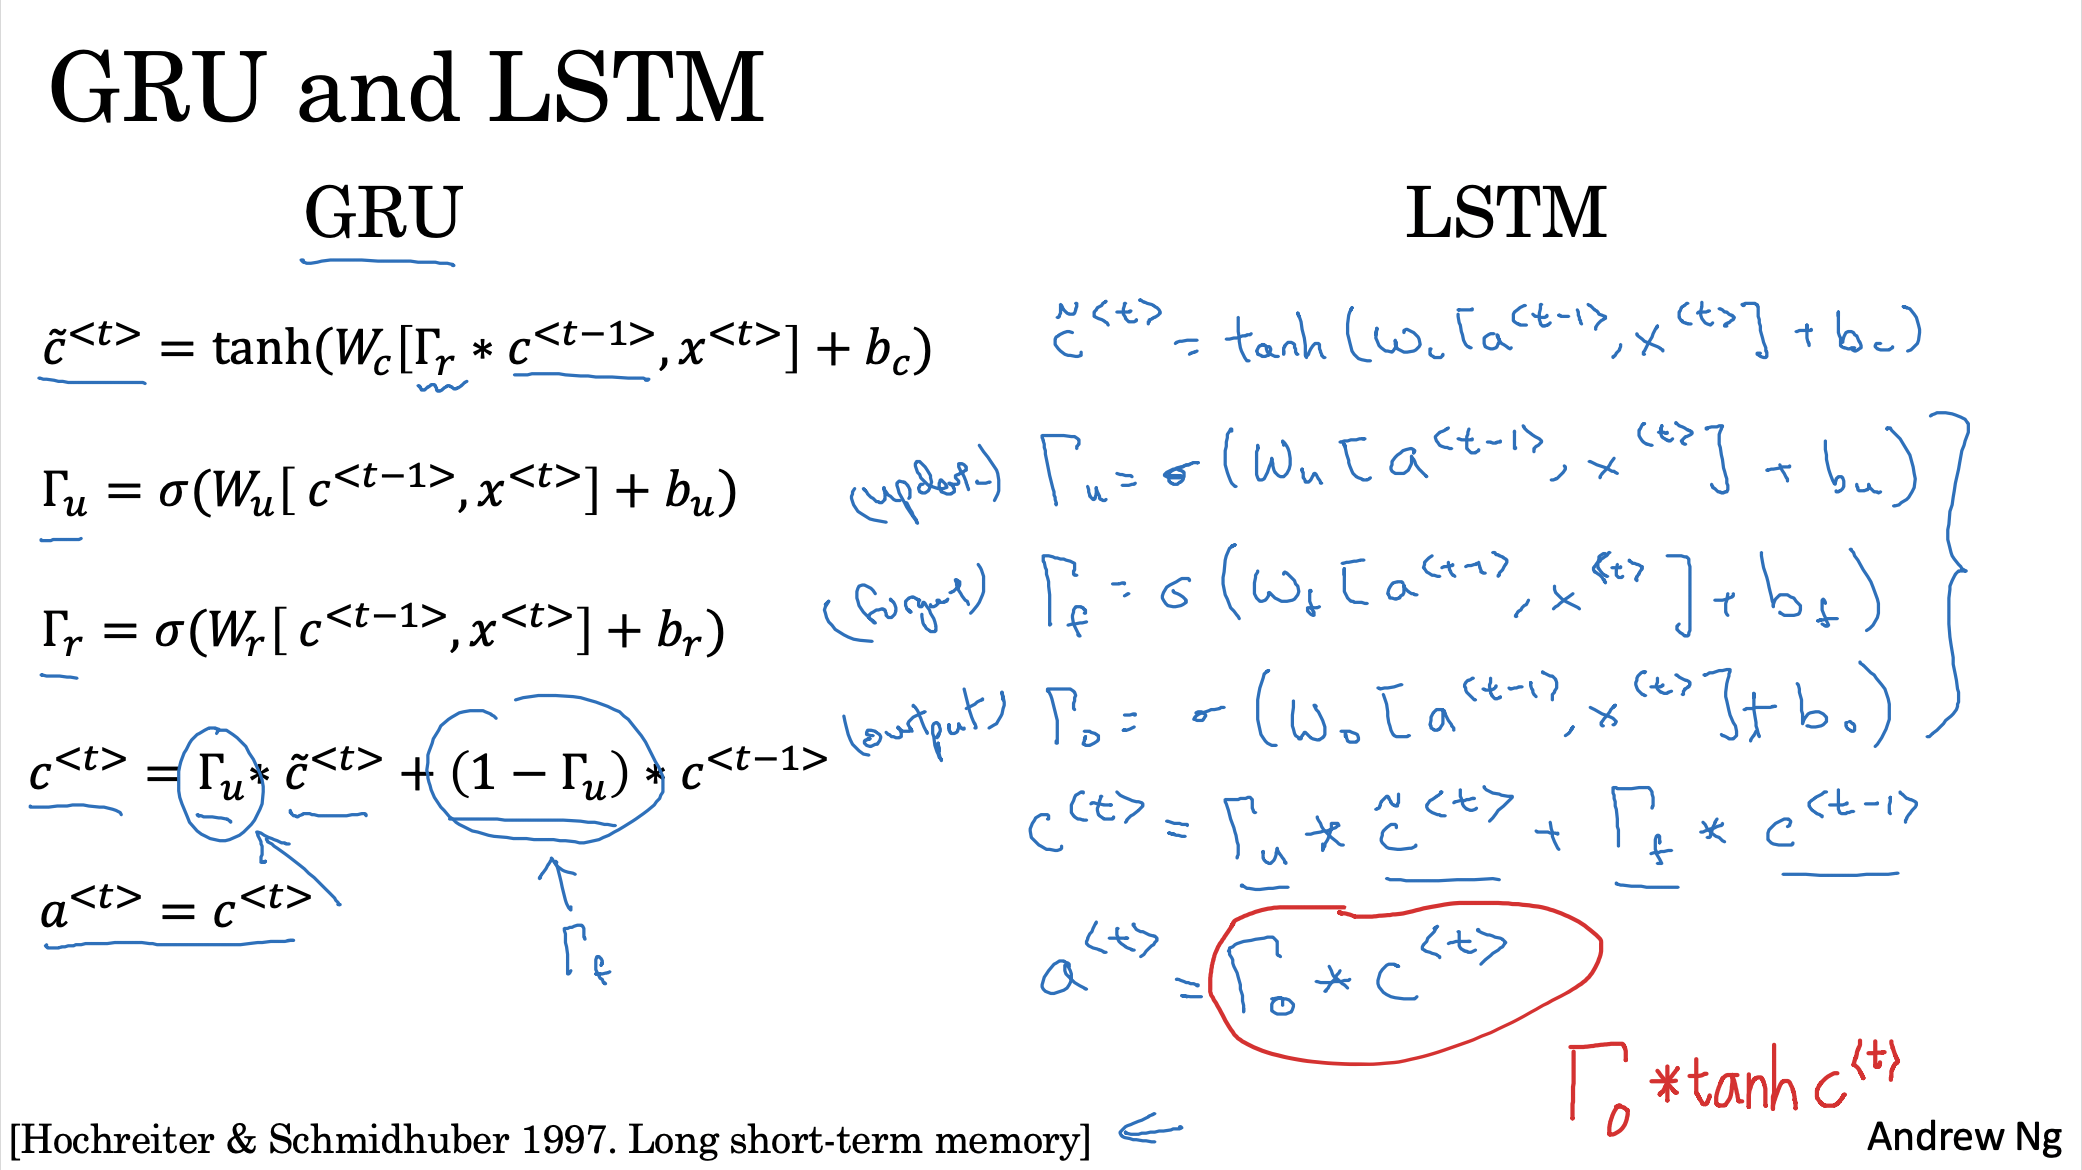
在之前的GRU视频中,我们学习了以下方程:
- 𝑎ᵗ = 𝑐ᵗ(即输出激活等于内存单元的值)。
- GRU有两个门:更新门(γᵤ) 和 相关性门(γᵣ)。
- 𝑐(tilde)ᵗ 是内存单元的候选更新值。
LSTM比GRU更强大
LSTM 是GRU的更强版本,由 Sepp Hochreiter 和 Jürgen Schmidhuber 提出。LSTM的一个显著特点是能够更好地解决 梯度消失 问题,这使得它在捕获长期依赖方面比GRU更为强大。
LSTM的方程比GRU复杂,具有 三个门,而不是像GRU那样只有两个:
- 更新门(γᵤ):控制是否使用候选内存单元更新当前的内存单元。
- 遗忘门(γᶠ):控制是否遗忘上一个时间步的内存单元。
- 输出门(γᵒ):控制当前内存单元对输出的影响。
LSTM的方程
- 内存单元:𝑐ᵗ = γᵤ * 𝑐(tilde)ᵗ + γᶠ * 𝑐ᵗ₋₁
- 输出激活:𝑎ᵗ = γᵒ * tanh 𝑐ᵗ
LSTM的关键组成部分
LSTM的门控机制
LSTM有三个主要的门控:
- 更新门(Update Gate):决定是否更新内存单元。
- 遗忘门(Forget Gate):决定是否忘记先前的内存单元的内容。
- 输出门(Output Gate):决定当前内存单元对输出的影响。
如何工作?
- 计算遗忘门(Forget Gate):它基于当前的输入和上一步的激活来判断当前记忆单元是否需要被忘记。
- 计算更新门(Update Gate):它决定是否用新的候选值更新当前的内存单元。
- 计算输出门(Output Gate):最终,输出门决定内存单元对输出的影响。
LSTM的图示与直观理解
LSTM结构图
这是LSTM的一个经典结构图,帮助我们更直观地理解它的工作原理:
输入 𝑎ᵗ₋₁、𝑥ᵗ  ->  遗忘门(γᶠ)  ->  更新门(γᵤ)  ->  输出门(γᵒ)
                                 |
                            𝑐(tilde)ᵗ
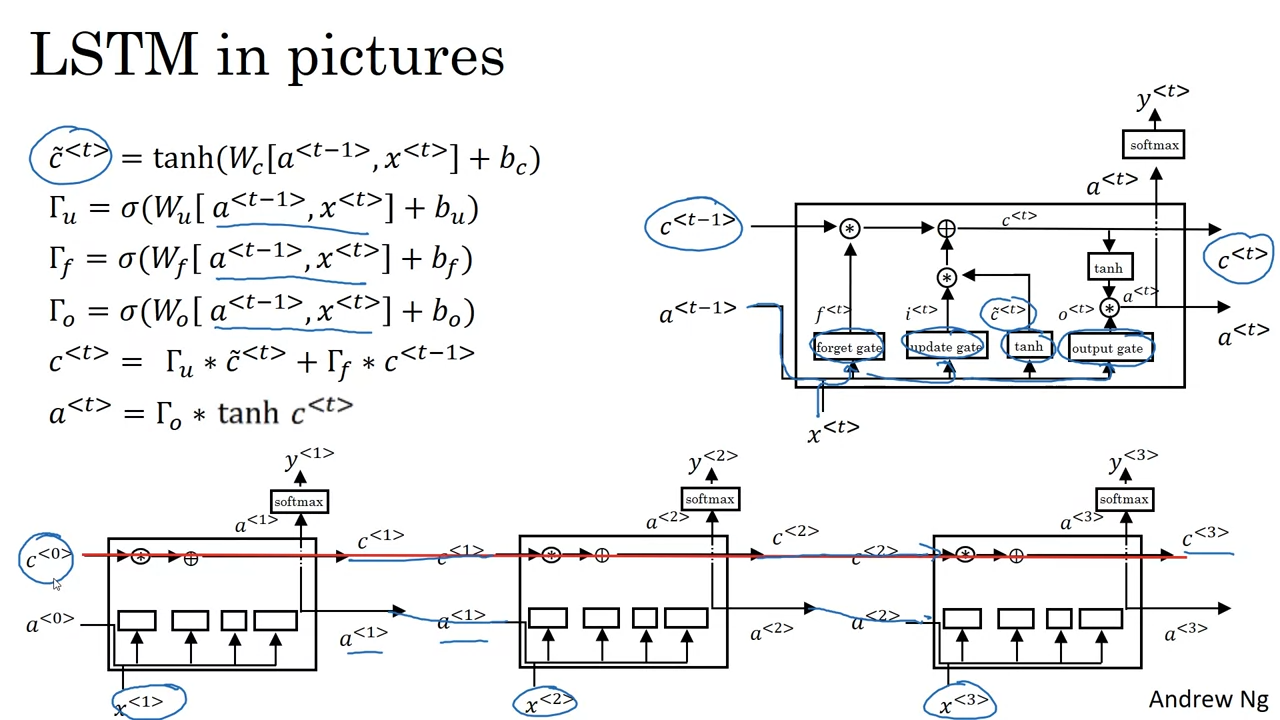
在此图中,LSTM单元的输入包括前一步的激活值和当前的输入值,它们一起计算 遗忘门、更新门 和 输出门。通过这些门的操作,LSTM能够有效地控制哪些信息需要遗忘,哪些需要记住,最终决定输出激活值。
LSTM的变化与扩展
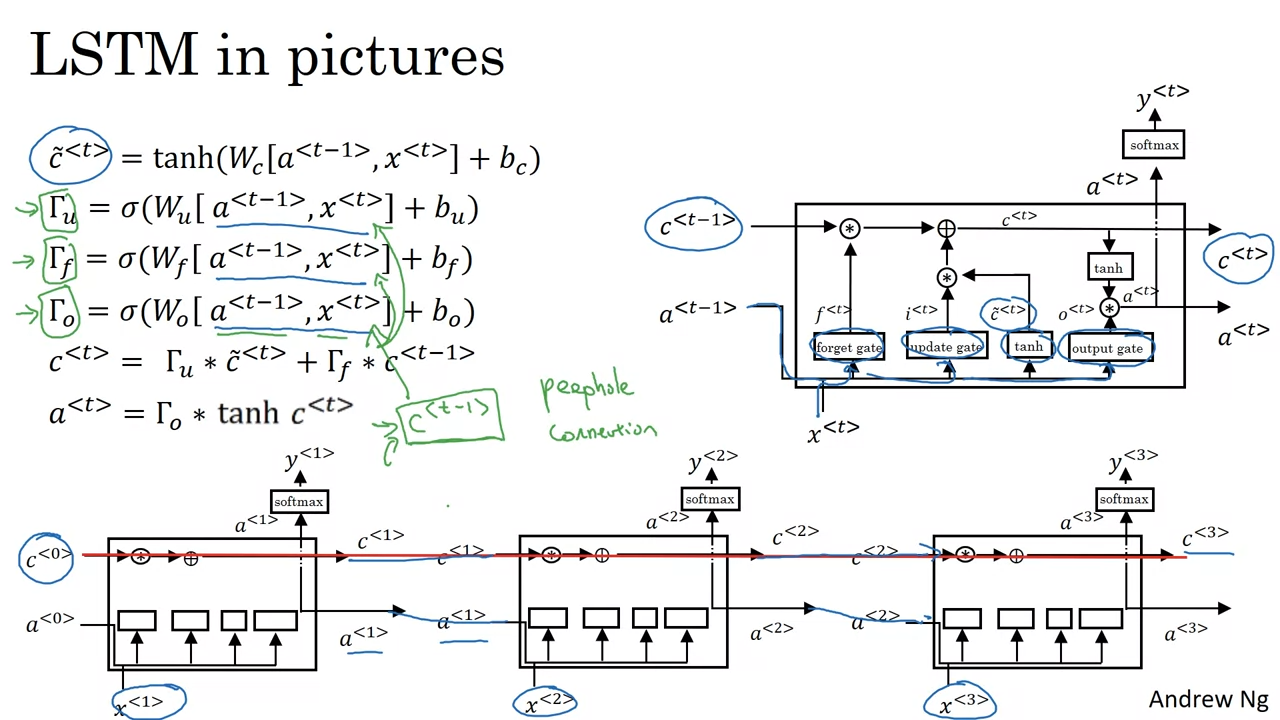
Peephole连接
有时,LSTM会使用一种叫做 Peephole连接(窥孔连接)的技术。在这种情况下,门控不仅依赖于 𝑎ᵗ₋₁ 和 𝑥ᵗ,还会依赖于上一步的内存单元 𝑐ᵗ₋₁。这种做法可以帮助提高模型的表现,尤其是在一些复杂任务中。
GRU vs LSTM
选择使用GRU还是LSTM?
- GRU:相比LSTM,GRU的结构更简单,计算速度较快,因此在构建大规模网络时,GRU具有一定的优势。
- LSTM:LSTM具有更强的表现力,因为它有三个门,可以更加灵活地控制信息流,因此在处理复杂问题时,LSTM通常表现得更好。
GRU与LSTM的选择建议
- LSTM:历史上已经证明在许多任务中效果更好。如果你不确定应该选择哪个模型,可以首先尝试使用LSTM。
- GRU:近年来,GRU因其简洁性和较低的计算开销,逐渐受到越来越多的青睐。如果你需要在较大的数据集上进行训练,GRU可能是一个不错的选择。
总结
- LSTM和GRU 都能够有效捕获 长期依赖,解决 梯度消失 问题。
- LSTM 在灵活性和表现力上优于 GRU,但 GRU 在简洁性和计算速度上更具优势。
- 选择 GRU 或 LSTM 取决于具体的任务需求和数据集规模。
通过使用 GRU 或 LSTM,你将能够构建出能够捕获 长距离依赖 的神经网络,从而处理更复杂的序列建模任务! 🚀
下一个视频: 我们将继续探讨 LSTM 和 GRU 的应用与优化技巧。