Module 02 · Natural Language Processing & Word Embeddings
Learning Word Embeddings学习词嵌入
在本视频中,我们将开始学习一些具体的 词向量学习算法。在深度学习的历史上,最初应用于学习词向量的算法其实相对较为复杂,但随着时间的推移,研究者们发现可以使用越来越简单的算法,依然能得到非常好的结果,特别是对于大规模数据集来说。
从复杂到简单的算法
最初的算法相对复杂,而现在一些最流行的算法已经简化到几乎让人感到神奇的程度 —— 如此简单的算法,怎么可能起作用呢?
- 我将首先介绍一些 稍微复杂的算法,因为这样更容易帮助大家理解它们为何能起作用。
- 然后,我们将简化这些算法,并展示一些简单的算法,依然能够产生非常好的结果。
神经网络语言模型的构建
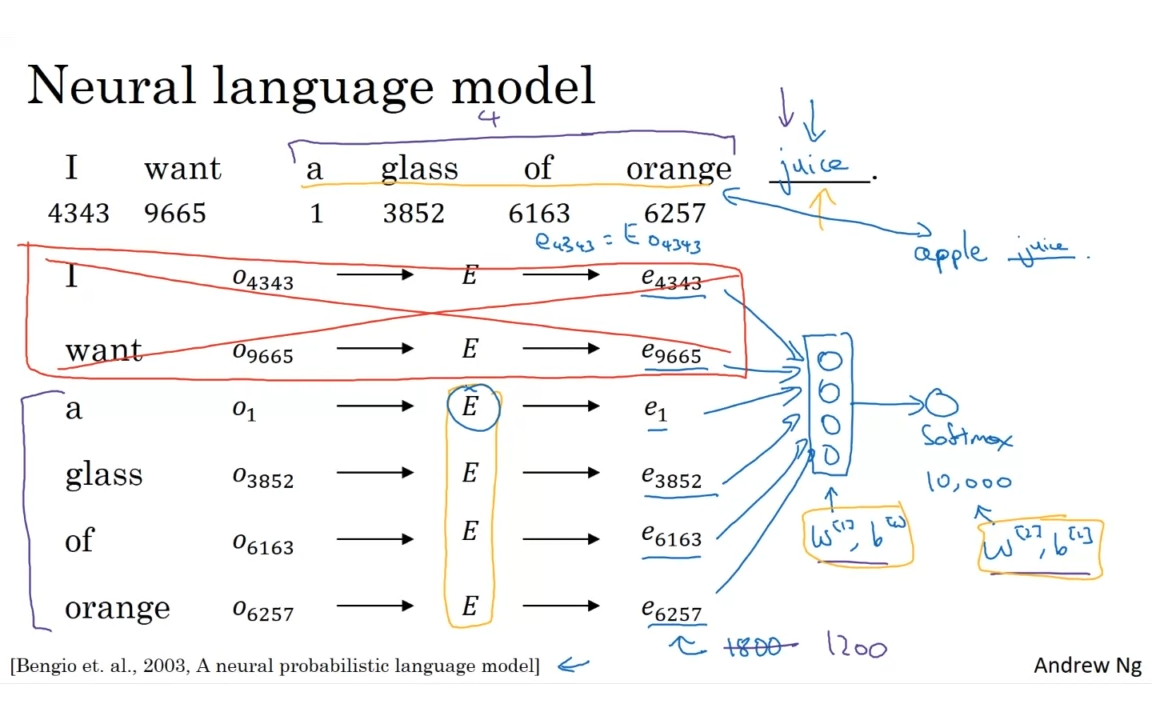
让我们从构建一个 神经网络语言模型 开始。在训练过程中,我们希望神经网络做的是:输入一段话,预测序列中的下一个词。
例如:
- 输入句子:"I want a glass of orange",然后预测下一个词。
每个单词下方都有词汇表中该单词的索引值。
神经网络构建步骤
- 构建 One-Hot 向量:我们先从 "I" 开始。
- 假设 "I" 是词汇表中的第 4343 个单词,那么它的 one-hot 向量 就是一个 10,000维 的向量,在位置 4343 处是 1,其他地方是 0。
- 矩阵乘法获取词向量:
- 接下来,使用一个 嵌入矩阵(E),通过 E × One-Hot 向量 得到该单词的 嵌入向量(embedding vector)。
- 对于单词 "want",它的 one-hot 向量 是 9665,然后用矩阵 E 乘以该向量,得到它的 嵌入向量。
- 神经网络层次结构:
- 将每个单词的 300维嵌入向量 输入到一个神经网络中,通过神经网络的 Softmax 层 来预测下一个词。
- Softmax 层 的作用是,在 10,000 个可能的输出中预测下一个单词。
例子
假设训练数据中出现了单词 "juice",神经网络的目标是预测出 "juice" 是序列中的下一个词。
- 网络的 隐藏层 会有自己的参数,比如 W1 和 B1,而 Softmax 层 也会有自己的参数 W2 和 B2。
嵌入矩阵与神经网络
- 输入的向量会有 6个词(如例子中提到的 6 × 300维),将这些词嵌入向量拼接在一起形成一个 1800维 的输入向量。
- 使用 固定的历史窗口:例如,选择使用 前4个词 作为上下文来预测下一个词。
窗口大小与上下文选择
- 如果使用固定窗口,如选择 4个单词 作为上下文,这样即使是非常长的句子也能适应。
- 神经网络的输入向量就是这 1,200维的向量,包含了前4个词的嵌入向量。
通过这种方式,我们可以通过训练一个神经网络来预测文本中的下一个词,并从中学习到 词向量。
模型参数与训练
- 模型的参数 包括嵌入矩阵 E 和 神经网络的权重(W1, W2)。
- 我们通过 梯度下降(Gradient Descent) 来优化这些参数,使模型能够尽可能准确地预测下一个词。
- 通过这样的学习过程,模型会学到 相似词的嵌入向量,比如 "orange" 和 "apple",因为在训练过程中它们经常同时出现在类似的上下文中,导致它们的嵌入向量变得相似。
进一步简化的算法:Skip-Gram 模型
我们将通过一个更复杂的句子来引入更简单的算法。假设训练集中有如下句子:
"I want a glass of orange juice to go along with my cereal."
目标
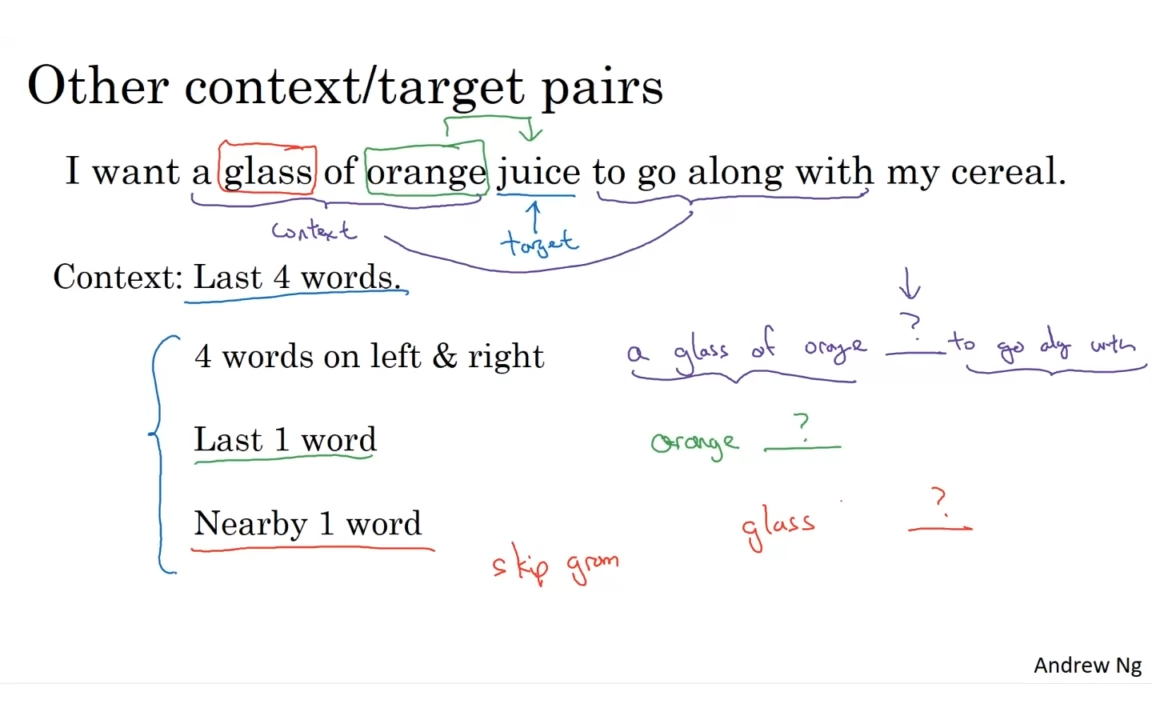
- 使用 前后单词 作为上下文,预测中间的目标词(例如"juice")。
学习算法的不同上下文
- 上下文是前后的4个单词:
- 通过 4个左词 和 4个右词 来预测目标词。
- 简化的上下文: 例如,只使用 前一个词(例如“orange”),预测下一个词(“juice”)。
- 更简单的上下文: 使用与目标词 相邻的词(如“glass”),来预测目标词。
Skip-Gram 模型
- Skip-Gram 是一种更简单的算法,使用的是 单词上下文窗口。
- 在这个模型中,上下文窗口 可以非常小,比如只使用一个 相邻的词 来预测目标词。
- 即便上下文非常简单,这种算法依然能够产生非常有效的词向量。
总结
- 本视频介绍了如何通过构建 语言模型 来学习词向量,特别是如何使用神经网络来预测下一个词,并通过这种方式学习到词向量。
- 我们还看到了如何通过更简化的 Skip-Gram 模型 来进一步优化学习过程,即使上下文窗口很小,依然能有效学习到好的词向量。
接下来的视频中,我们将介绍 Word2Vec 模型,并进一步探讨如何使用更简化的上下文和算法来学习词向量。