Module 02 · Natural Language Processing & Word Embeddings
GloVe Word VectorsGloVe 词向量
在自然语言处理(NLP)领域,除了 Word2Vec 和 Skip-Gram 模型,还有一个算法近年来也获得了不少关注,那就是 GloVe(Global Vectors for Word Representation)。虽然 GloVe 算法没有 Word2Vec 那么流行,但它因其简单性而受到一些人的喜爱。让我们一起来了解一下这个算法的基本原理和实现!🔍
GloVe 算法概述
背景与定义
GloVe 算法由 Jeffrey Pennington、Richard Socher 和 Chris Manning 提出,旨在通过对 词汇全局共现统计 的建模来学习词向量。与前面我们讨论的基于上下文窗口的模型不同,GloVe 强调全局统计信息的使用,即词与词之间的共现频率。
- 目标:通过对全局词汇共现信息的建模,学习能够有效表示单词的向量。
训练过程
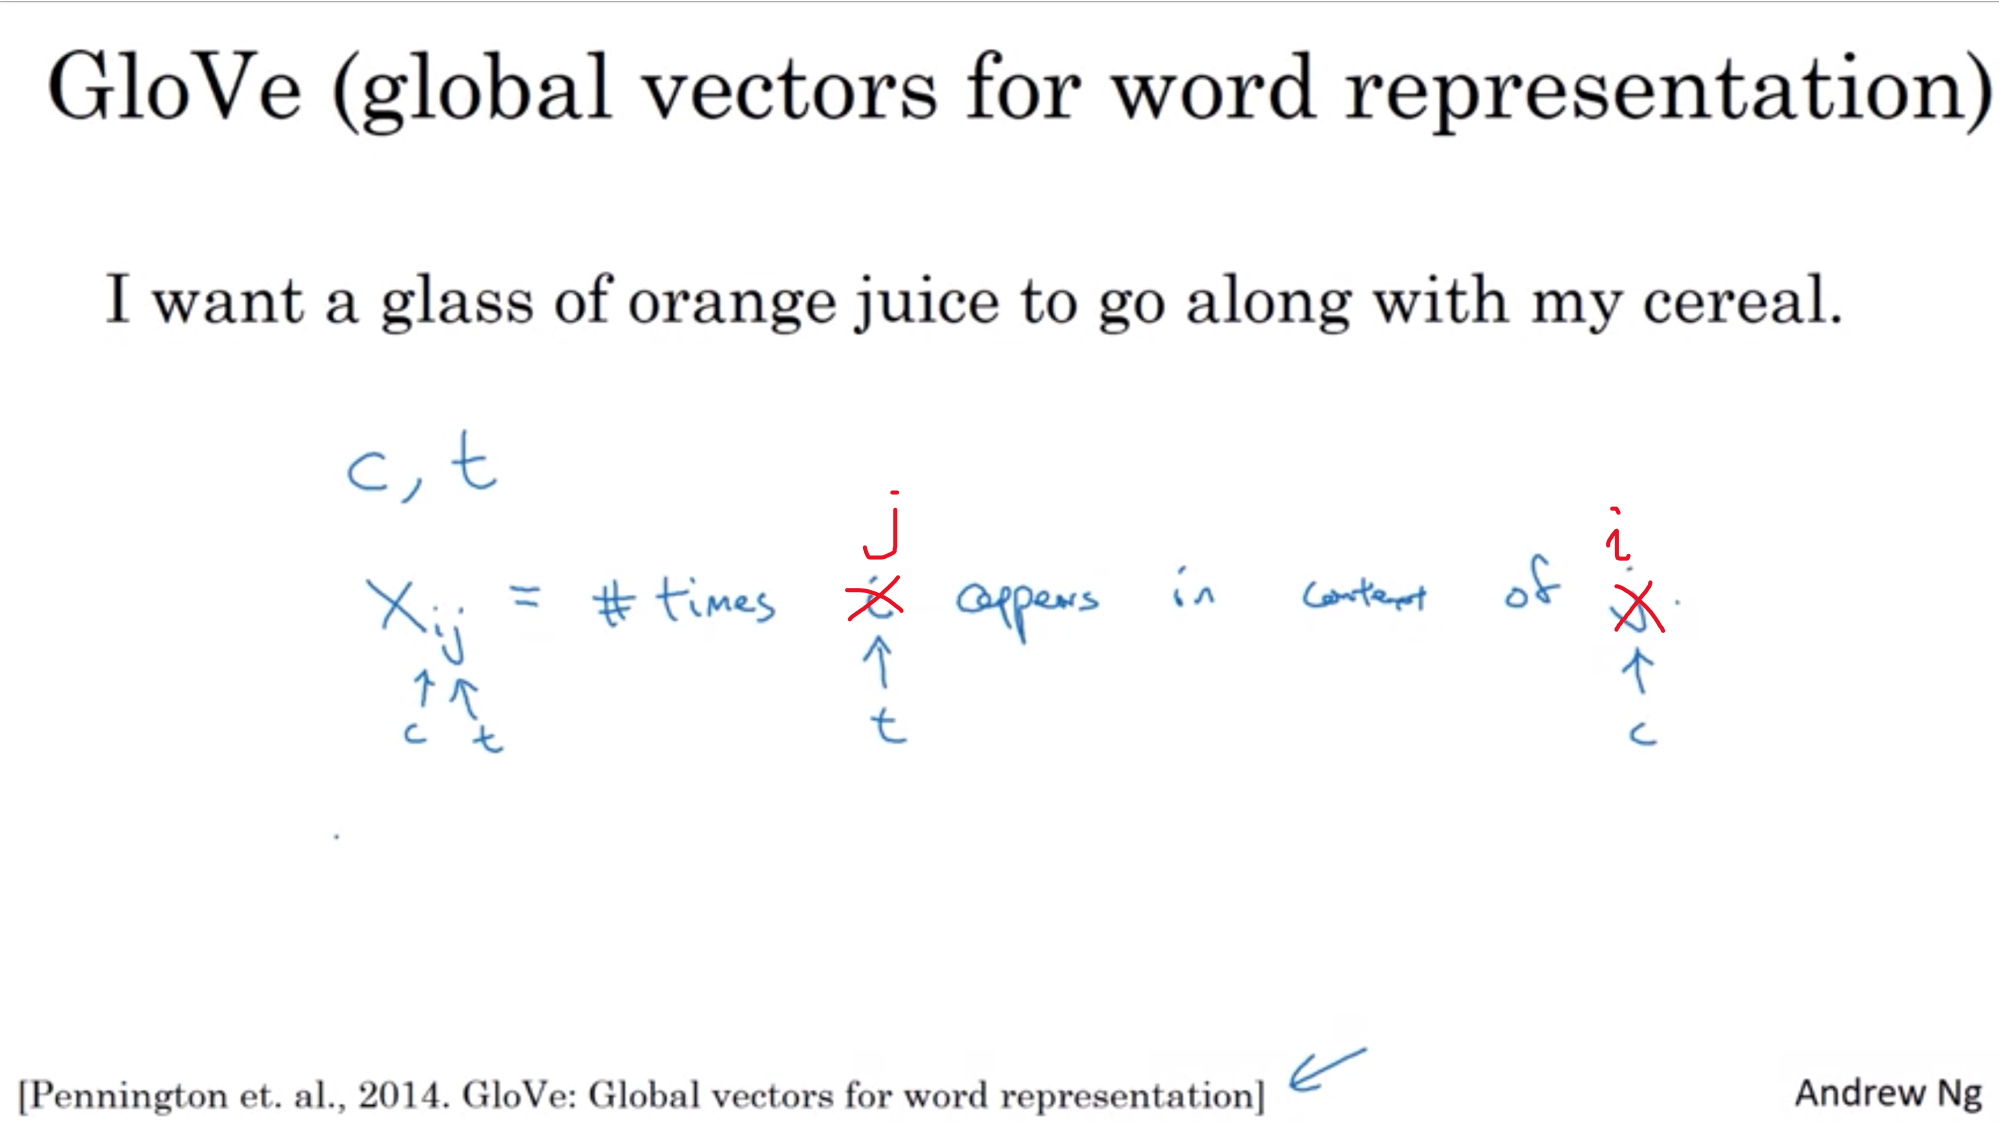
在 GloVe 中, 被定义为单词 i 在单词 j 上下文中出现的次数。具体来说,GloVe 模型通过以下步骤来计算词向量:
- 统计共现矩阵:计算每对单词的共现次数 ,即单词 i 在单词 j 的上下文中出现的次数。
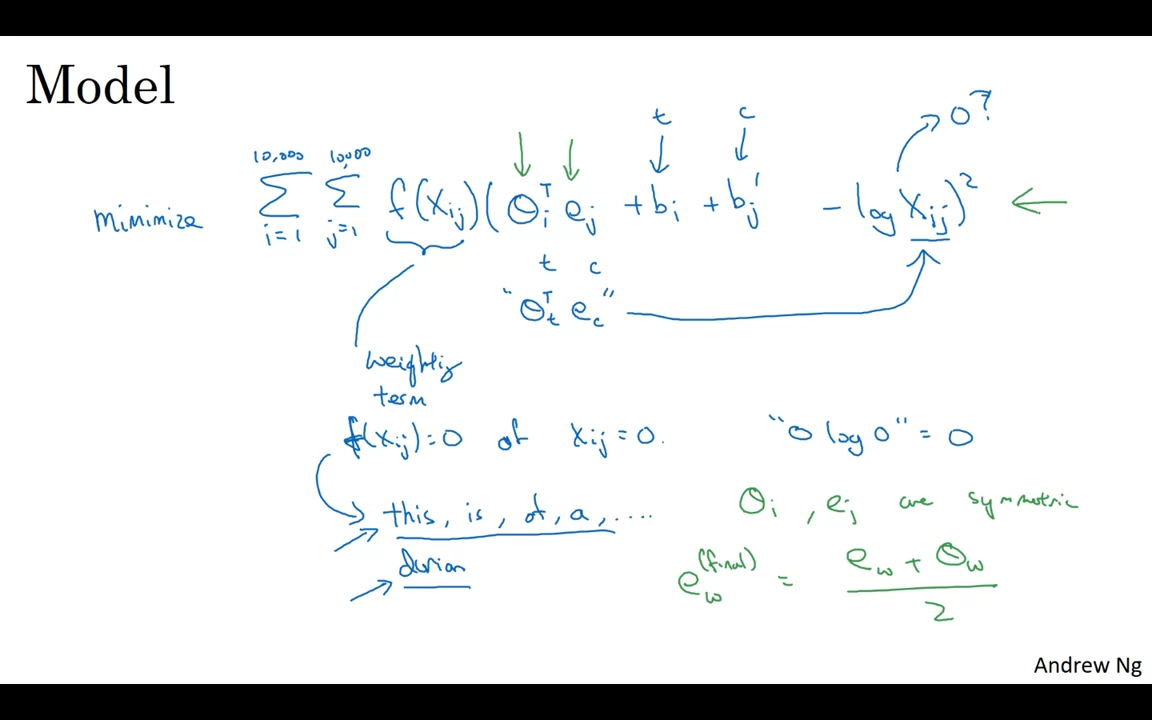
- 优化目标:通过优化以下目标函数来学习词向量:
其中:
- 和 分别表示单词 i 和单词 j 的嵌入向量。
- 是 i 和 j 共现的次数。
- 通过最小化上述差异,模型学习到的词向量能够有效反映词汇之间的关系。
问题处理
处理 X_ij 为 0 的情况
- 如果 X_ij = 0,则 log(0) 为负无穷大,因此我们通过引入加权项来避免这种情况。加权项在 X_ij = 0 时为零,从而使得该项不参与计算。
加权函数 F(X_ij)
- 对于一些高频词(如:“the”、“is”、“of”),它们在语料中出现非常频繁,可能会对训练过程产生过大影响。为了避免这种情况,GloVe 引入了加权函数 F(X_ij),来平衡高频词和低频词的影响。
- 这种加权函数 F(X_ij) 旨在保证对频繁词的影响不过大,同时对不常见的词也能给予足够的关注。
对称性
在 GloVe 中, 和 是对称的,它们扮演的角色基本相同。因此,在训练过程中,它们可以通过对称的方式来优化,而不像传统的模型中,θ 和 e 的角色是不同的。
对称性示例:
- 训练完成后,对于每个词,最终的词向量 e 可以是 θ 和 的平均值: 这种对称性简化了词向量的学习过程。
GloVe 算法的优点
- 利用全局信息:GloVe 通过考虑词汇在整个语料库中的共现信息,而不仅仅是局部上下文,因此能捕捉到词汇间的全局关系。
- 简洁高效:与其他基于上下文窗口的模型相比,GloVe 的数学公式较为简洁,训练过程高效。
- 可解释性:虽然无法保证每个维度都有明确的物理含义,但 GloVe 能够学习到有效的词向量,尤其在语义相似度和类比任务中表现优异。
GloVe 算法的局限性
尽管 GloVe 在许多任务中表现出色,但也存在一些局限性:
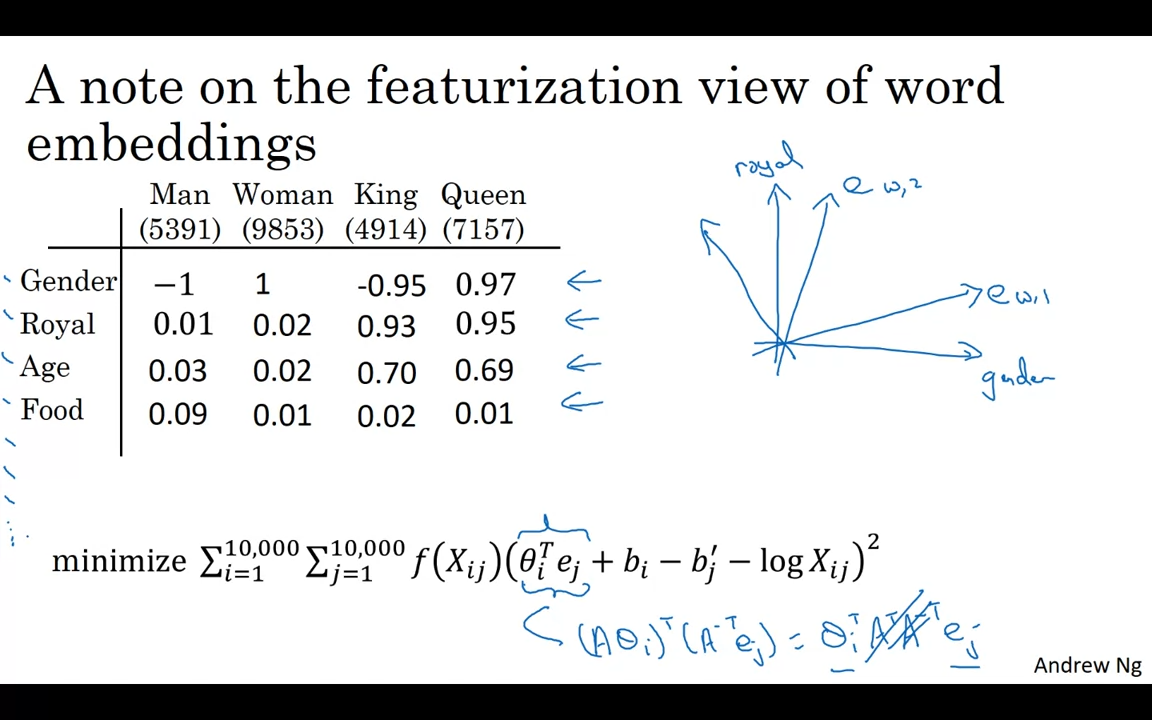
- 解释性不足:GloVe 算法并不能保证词向量的每一维度都能与具体的语义特征(如性别、年龄、食物等)直接对接。
例如,如果我们假设词向量的第一维表示 性别,第二维表示 王室,那么在实际训练中,这些维度可能并不是彼此独立的,而是通过某种线性变换相互组合。由于 GloVe 使用的是线性模型,因此可能无法直接给每个维度赋予直观的语义含义。 - 维度间的线性变换:虽然 GloVe 可以学习到有效的词向量,但这并不意味着每个维度都与我们容易理解的特征严格对应。实际上,词向量的维度可能是不同语义特征的线性组合。
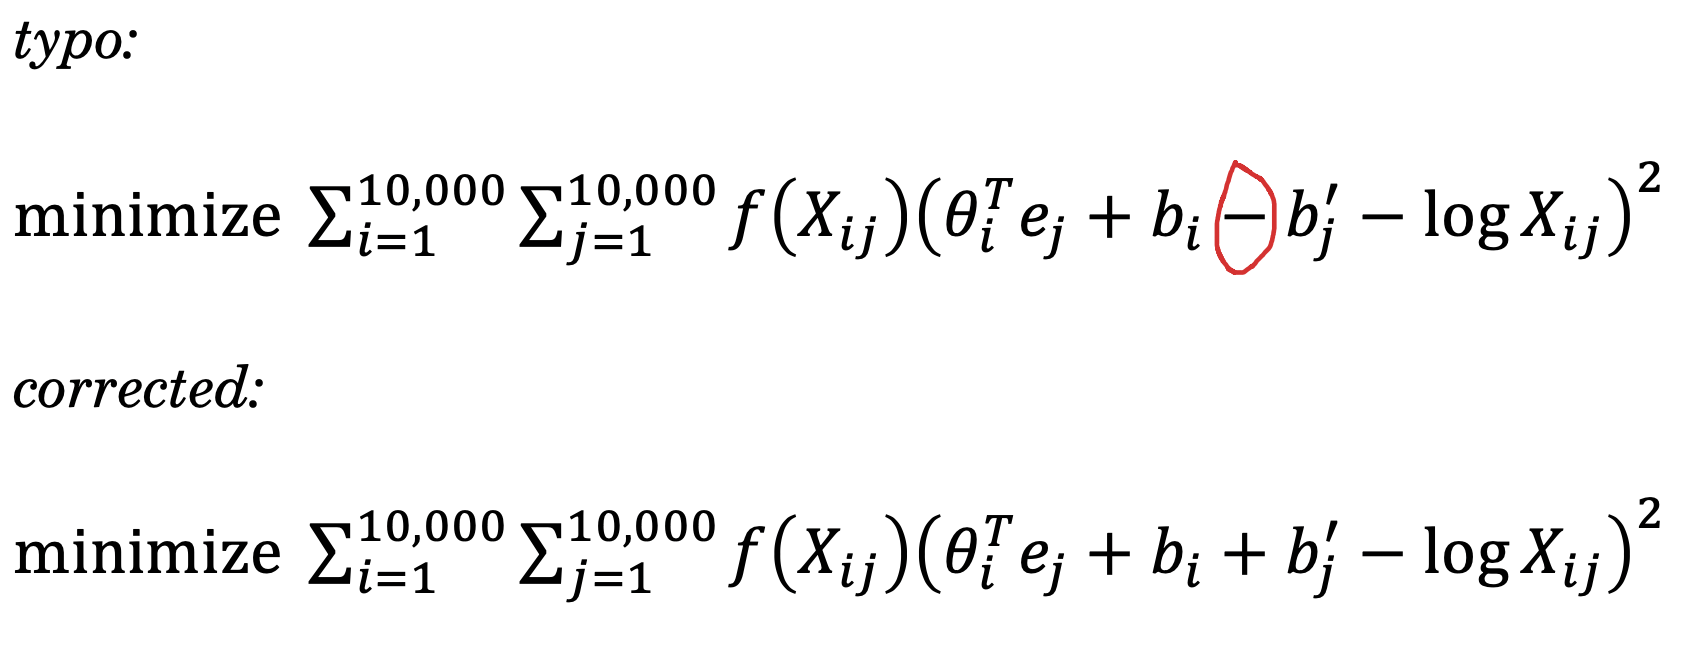
总结与展望
通过 GloVe 算法,我们可以高效地学习到有效的词向量,这些词向量能够捕捉到单词之间的语义关系。尽管 GloVe 算法的实现相对简单,但它依然是一个强大的工具,能够在很多 NLP 任务中发挥重要作用。
然而,值得注意的是,GloVe 并不能保证每个词向量维度都具有明确的语义含义,而是通过优化全局共现信息来学习有效的词向量。
在接下来的学习中,我们还将介绍如何使用这些算法来解决情感分类等问题。希望大家能够在实践中深入理解并运用这些词向量学习算法!🚀