Module 03 · Sequence Models & Attention Mechanism
Trigger Word Detection触发词检测
在深度学习和序列模型的学习过程中,触发词检测系统(Trigger Word Detection System)是一个非常有趣且实用的应用。随着语音识别技术的发展,越来越多的设备可以通过你的声音来激活,称为触发词检测系统。
什么是触发词检测系统?
触发词检测系统的工作原理非常简单,它能识别出某个特定的词汇(触发词),并在检测到该词时启动设备。
触发词检测的常见应用
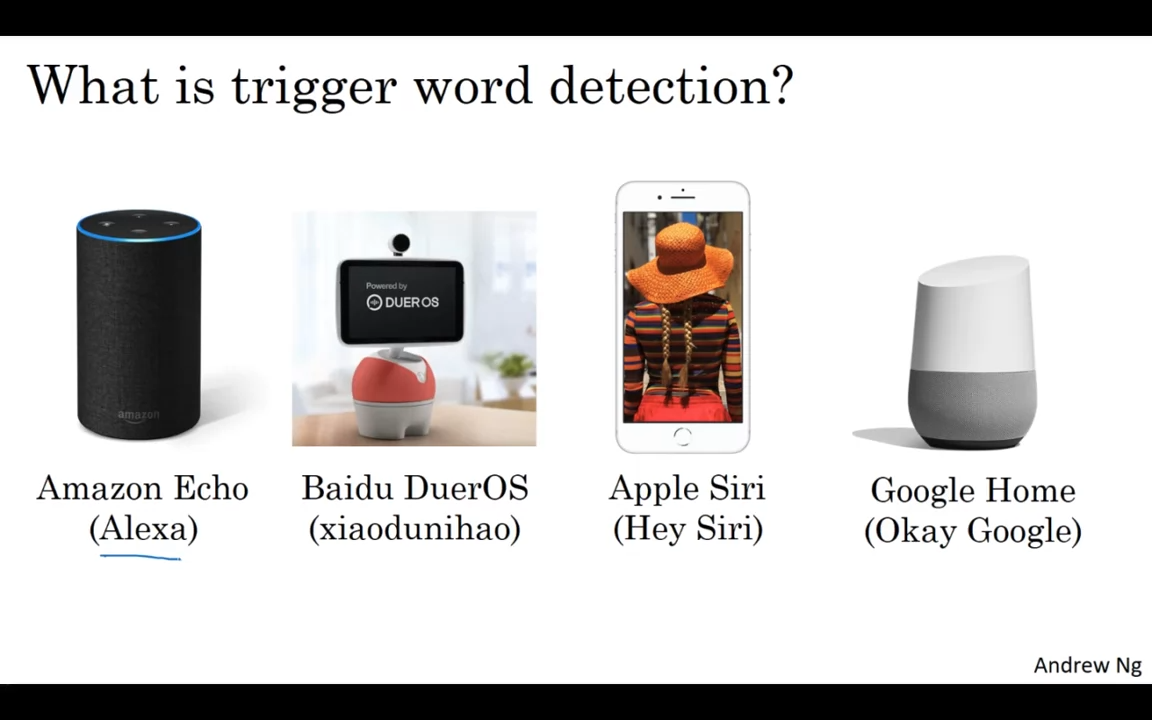
- Amazon Echo:唤醒词为 Alexa
- Baidu DuerOS:唤醒词为 xiaodunihao
- Apple Siri:唤醒词为 Hey Siri
- Google Home:唤醒词为 Okay Google
例如,当你在客厅说出 "Alexa, what time is it?",Amazon Echo 就会被激活并响应你的语音查询。只要检测到特定的唤醒词,设备便会激活执行指令。
如何构建一个触发词检测系统?
尽管触发词检测算法的研究还在不断发展,尚未达成广泛共识,但我们可以通过一个简单的示例来构建触发词检测系统。
步骤概述
- 音频输入与特征提取:
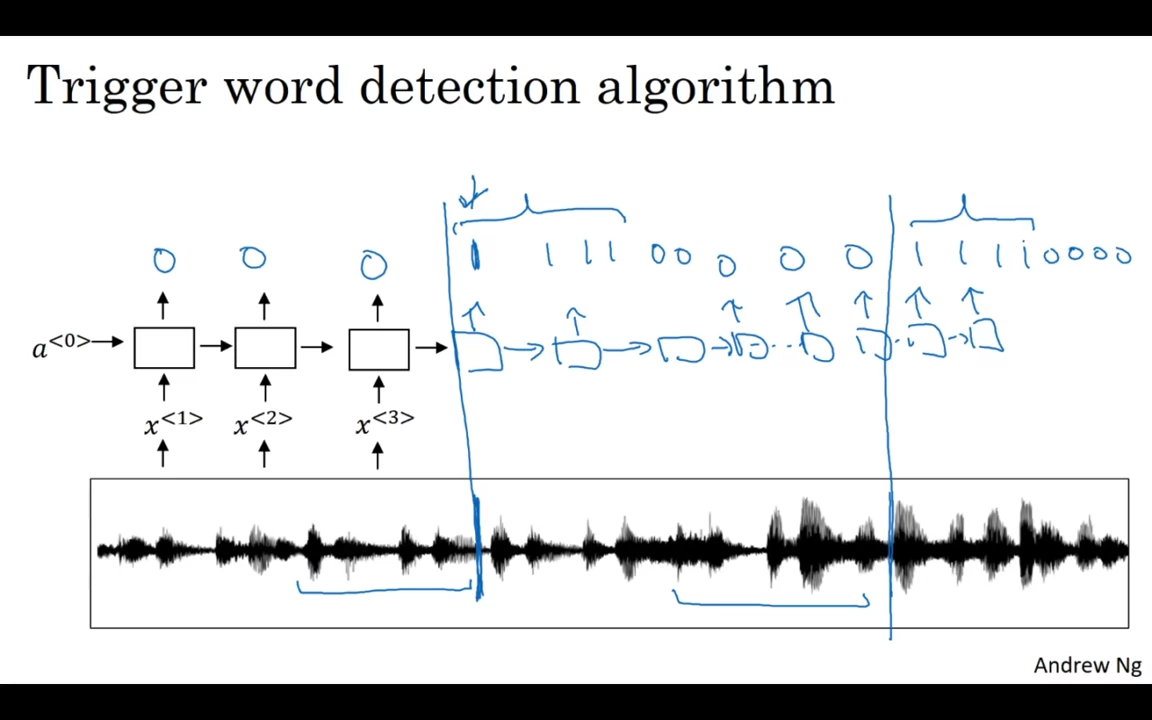
- 首先,我们将一个音频片段作为输入,通常会计算音频的频谱图(Spectrogram)特征。
- 音频特征可以表示为:x_1, x_2, x_3 等。
- 通过RNN处理音频特征:
- 这些特征会传入**循环神经网络(RNN)**中进行处理。
- 目标标签的定义:
- 如果音频片段中某个时刻刚好是触发词被说出的时刻(如**"Alexa"**),那么我们就将该时刻及之后的目标标签设置为 1,而在此之前的目标标签设置为 0。
- 例如:当触发词(如**"Alexa"**)说出后,目标标签设置为 1,在此之前设置为 0。
训练数据的标签平衡问题
这种标签标注方案虽然可以正常工作,但有一个小小的缺点:它会导致训练集中的标签不平衡,0的数量远远多于1,因为触发词通常出现的频率较低。
解决方案
一种可行的解决方案是:
- “黑客”方式(hack)
不仅在触发词后面的一个时间步设置为1,还可以将一段时间内的多个时间步都设置为1,直到恢复为0。
这样可以稍微平衡标签0和标签1的比例,避免训练集过于偏向标签0。
触发词检测系统的训练示意图
| 时间步 | 音频特征输入 | 标签 (Y) |
|---|---|---|
| t1 | x1 | 0 |
| t2 | x2 | 0 |
| t3 | x3 | 1 |
| t4 | x4 | 1 |
| t5 | x5 | 0 |
在上述表格中,假设 t3 和 t4 是触发词(如**"Alexa"**)出现的时刻,那么目标标签在 t3 和 t4 处都被设置为 1,而在其他时刻则为 0。
训练与实践
通过这个训练方案,你可以开始实现一个简单的触发词检测系统。这个过程是深度学习的经典应用之一,通过调整标签的设置和训练策略,你可以训练出一个能够有效识别触发词的模型。
课程回顾与总结
在本课程中,你学习了多个深度学习与序列模型的核心概念:
- RNN(循环神经网络),包括GRU和LSTM
- 词嵌入(Word Embeddings),以及如何学习词的表示
- 注意力机制(Attention Model),并学会如何处理音频数据
这些概念和技术不仅为构建触发词检测系统奠定了基础,也能帮助你深入理解深度学习在语音识别中的应用。
🎉 接下来的挑战:
在本周的编程练习中,我希望你能动手实现并实践这些想法,构建一个有效的触发词检测系统。