Module 01 · Recurrent Neural Networks
Sampling Novel Sequences采样生成新序列
在训练好 RNN 语言模型 后,我们可以通过 采样(Sampling) 来生成新的句子或文本,从而直观感受模型学到了什么。本视频将详细讲解如何从训练好的语言模型中采样新句子,并探索 词级别(Word-Level) 和 字符级别(Character-Level) 语言模型的差异与应用。
1.从语言模型中采样文本
1.1模型的工作原理
语言模型的目标是为某个句子分配一个概率,例如:
通过从这个分布中 采样(Sampling),我们可以生成符合模型理解的句子。
1.2采样过程
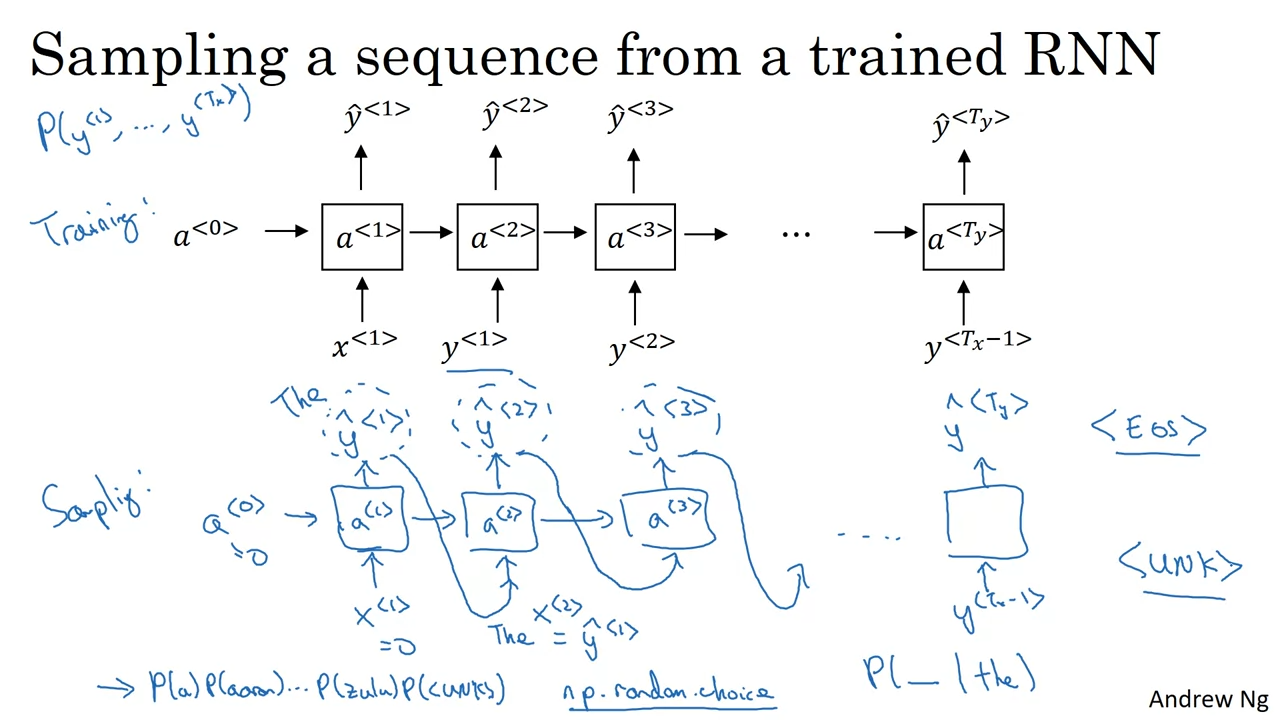
步骤 1生成第一个单词
- 输入 初始状态 x_1 = 0, a_0 = 0,通过 Softmax 输出第一个单词的概率分布。
- 根据该分布随机采样一个单词 y_1:
- 使用函数如
np.random.choice从概率分布中选择一个单词。
- 使用函数如
步骤 2生成后续单词
- 将采样到的 y_1 作为输入 x_2,通过 Softmax 输出下一个单词 y_2 的概率分布。
- 按照概率分布继续采样。
步骤 3结束条件
- 如果词汇表中包含 EOS(End of Sentence) 标记,则当生成 EOS 时停止采样。
- 如果没有 EOS 标记,可以预定义句子长度(例如 20 或 100 个单词)。
步骤 4处理未知单词
- 如果采样到 UNK(未知词),可以:
- 丢弃该结果并重新采样。
- 或保留它,视任务需求而定。
1.3采样示例
假设句子以“the”开始:
- 第 1 步:模型预测第一个单词是“the”,然后采样。
- 第 2 步:输入“the”,预测下一个单词可能是“cat”、“dog”等,继续采样。
- 重复以上步骤,直到生成完整句子或达到预定义长度。
2.字符级别 vs. 词级别语言模型
除了 词级别(Word-Level) 模型,还有 字符级别(Character-Level) 模型,其单位是字符而非单词。
2.1字符级别模型的特点
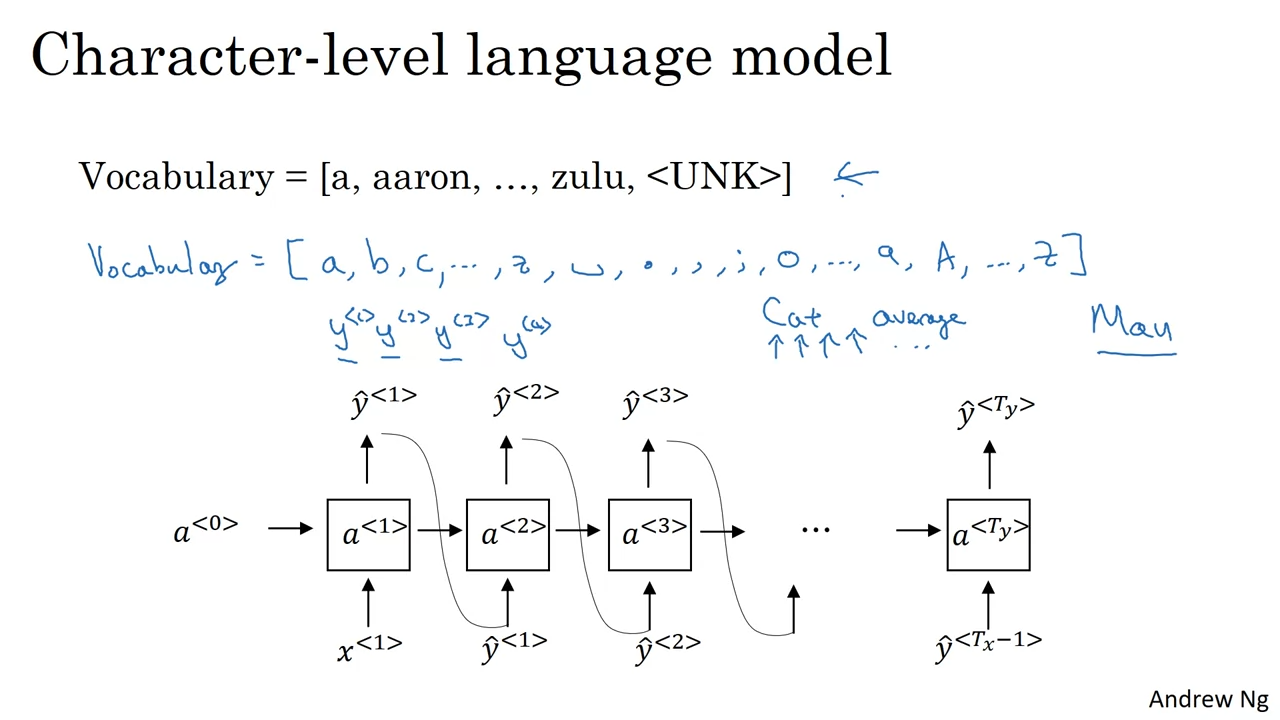
- 词汇表(Vocabulary): 包含字母(a-z)、数字(0-9)、空格和标点符号。
- 示例:句子 “Cats average 15 hours” 被分解为
- 优点:
- 无需处理未登录词(No Unknown Words):即使单词 “Mau” 未在训练集中,模型仍然可以为其分配概率。
- 更灵活,适用于小型专用词汇。
- 缺点:
- 序列更长:一个句子的字符数远多于单词数,导致训练复杂度增加。
- 长距离依赖建模较差:难以捕捉句子中远距离词汇之间的关系。
2.2词级别模型的特点
- 更擅长捕捉 长距离依赖。
- 适合绝大多数 NLP 应用。
- 可能遇到未登录词问题,但通过 UNK 标记可以缓解。
2.3字符级与词级模型的对比
| 特性 | 字符级别模型 | 词级别模型 |
|---|---|---|
| 粒度 | 字符(a-z,标点,数字等) | 单词 |
| 词汇表大小 | 小(例如 50-100 个字符) | 较大(例如 10,000+ 单词) |
| 未登录词处理 | 无需特殊处理 | 需要 UNK 标记 |
| 长距离依赖 | 表现较差 | 表现较好 |
| 计算复杂性 | 更高(序列更长) | 较低 |
| 适用场景 | 小型词汇任务,专用文本 | 常规 NLP 应用 |
3.采样文本的实际效果
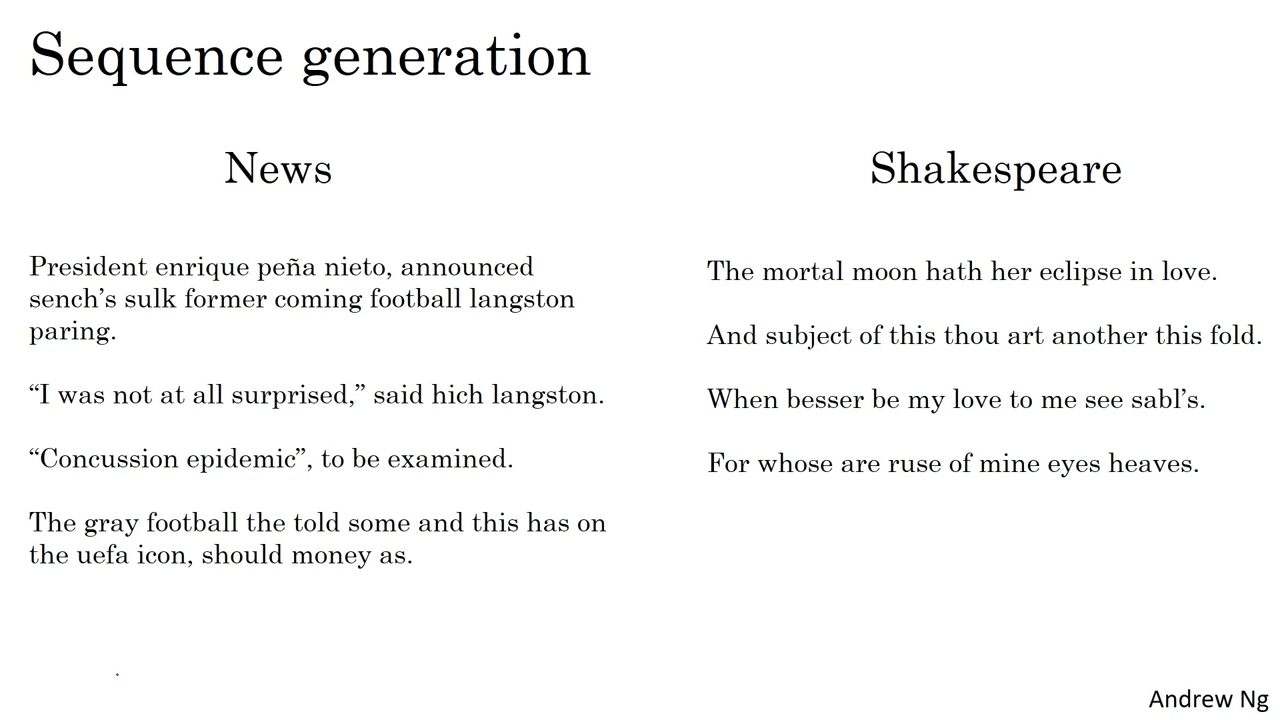
以下是基于训练数据生成的示例文本:
3.1新闻文本生成
生成文本:
“Concussion epidemic to be examined.”
看起来像新闻标题,但语法可能不完全正确。
3.2莎士比亚风格文本
生成文本:
“The mortal moon hath her eclipse in love. And subject of this thou art another this fold.”
这些示例展示了模型如何根据训练数据生成具有特定风格的文本。
总结与展望
通过本视频,我们学习了如何从语言模型中采样句子,并理解了词级别和字符级别模型的优缺点:
| 内容 | 描述 |
|---|---|
| 采样文本 | 使用 Softmax 概率分布逐步采样生成句子 |
| 词级别模型 | 适合大多数 NLP 应用,处理长距离依赖,可能需要处理未登录词问题 |
| 字符级别模型 | 更灵活,无未登录词问题,但训练更复杂,难以建模长距离依赖 |
接下来,我们将探讨 训练 RNN 的挑战,例如 梯度消失问题(Vanishing Gradients),并介绍更强大的模型,如 GRU 和 LSTM。这些技术将帮助我们克服训练中的困难,构建更强大的序列模型。
让我们继续探索吧! 🚀