Module 04 · Transformer Network
Transformer NetworkTransformer 网络
在之前的视频中,我们了解了 自注意力机制 和 多头注意力机制。现在,我们将把这些概念结合起来,构建完整的 Transformer 网络。下面,我们将带您一步一步地了解如何将这些注意力机制结合在一起,搭建 Transformer 架构。
步骤 1:输入与嵌入表示
我们将以句子 “Jane visite l'Afrique en septembre” 为例,展示如何通过 Transformer 进行翻译。为了简化,假设这个句子已经进行了嵌入(embedding),并且加入了句子的 开始标记(SOS) 和 结束标记(EOS)。
- SOS(开始标记):用来标记翻译的开始。
- EOS(结束标记):用来标记翻译的结束。
Transformer 网络的组成
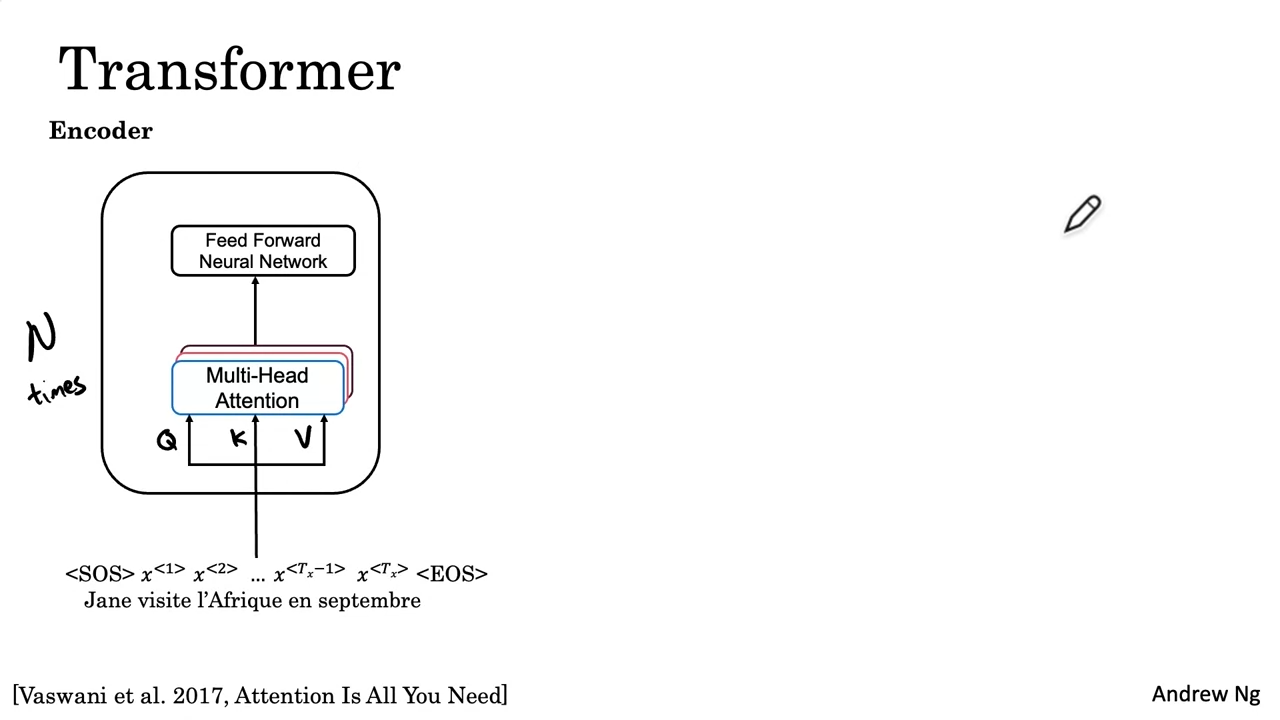
1.编码器(Encoder)
- 首先,嵌入向量被传递到 编码器块(Encoder Block)。
- 编码器块包含了 多头注意力层(Multi-Head Attention),正如我们在前面的部分所讲过的,输入的 Q、K 和 V 来自于句子的嵌入表示,以及对应的权重矩阵 W。
- 编码器块的输出会被传递给一个 前馈神经网络(Feed-Forward Neural Network),该网络帮助决定句子中的有趣特征。
- 在 Transformer 论文中,编码器块会被 n 次重复,通常 n=6。
2.解码器(Decoder)
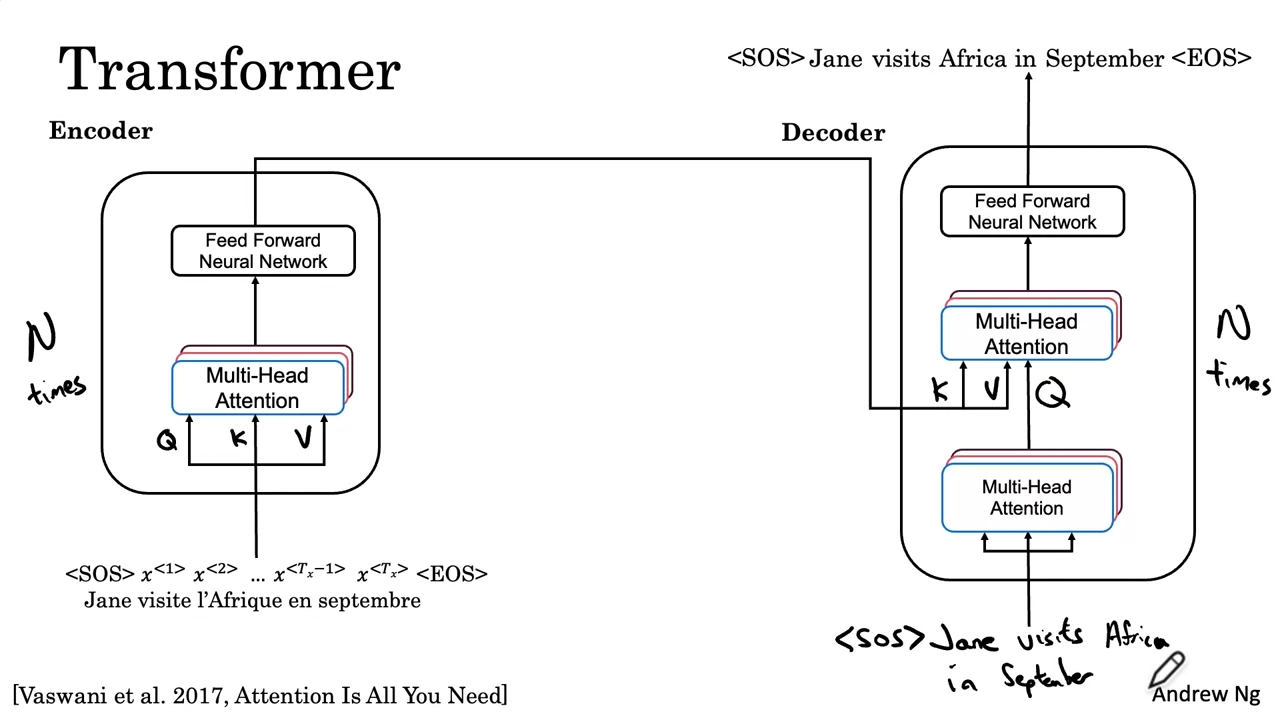
- 解码器块的目标是输出英文翻译。
- 第一个输出 是 开始标记(SOS),即翻译的开始。
- 在每一步,解码器块会输入当前已经生成的翻译(初始时,只有开始标记)。
- 解码器的第一个多头注意力块只使用 SOS 作为输入来计算 Q、K、V。
- 之后的多头注意力块将根据已经生成的部分(如 SOS)来预测下一个单词。
解码器的工作流程
- 第一个多头注意力块
输入是 SOS(开始标记),根据 Q、K、V 来进行计算。这个多头注意力块的输出用于生成下一个多头注意力块的 Q,而 K 和 V 则来自 编码器的输出。 - 第二个多头注意力块
这个块的输入包括 Q(来自上一步的输出)和 K、V(来自编码器)。解码器通过查询(query)已翻译部分,提取来自 编码器 的上下文信息,来预测下一个单词。 - 前馈神经网络
每个解码器块还会有一个前馈神经网络,帮助进行最终的预测。通过多次重复解码器块(通常也是 n=6),模型逐步生成每个词汇的翻译。
逐词生成与学习过程
- 在翻译过程中,解码器逐词生成翻译结果:
- 首次生成:“Jane”
- 接着生成:visite
- 然后是:l'Afrique
- 最后,生成 en 和 september,并最终输出 EOS(结束标记)。
Transformer 网络的额外优化
除了核心的编码器和解码器块,Transformer 网络还包括一些优化机制,使其能够更好地处理输入序列。
1.位置编码(Positional Encoding)
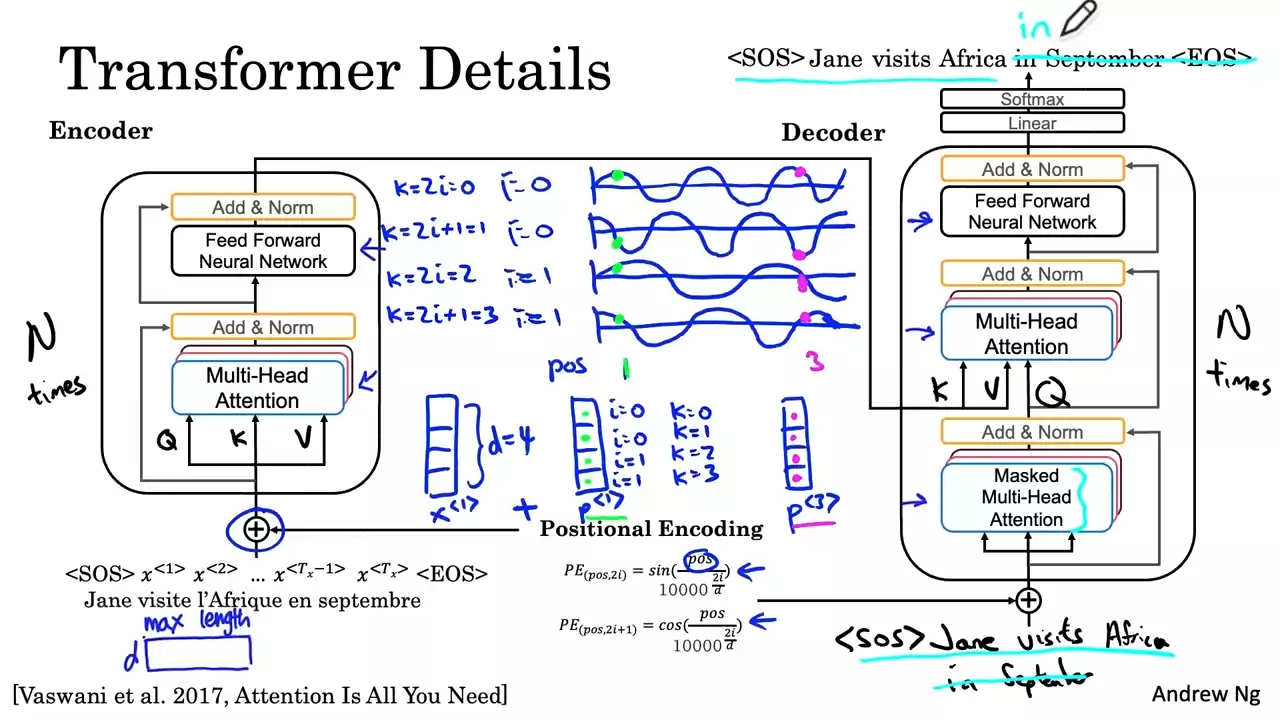
- 问题:自注意力机制本身并不关心词汇在句子中的位置,但句子的顺序对翻译至关重要。
- 解决方案:通过 正弦(sine)和余弦(cosine) 函数的组合为每个单词添加位置编码。
| 位置 | 编码维度 i | 公式 |
|---|---|---|
| Jane(位置 1) | 0、1、2、3 | 使用正弦和余弦生成的编码向量 |
| l'Afrique(位置 3) | 0、1、2、3 | 生成不同的编码向量 |
通过这种方式,模型能够理解每个词在句子中的相对位置,从而更好地进行翻译。
2.残差连接与归一化
- 残差连接:每个块的输入和输出通过残差连接传递,确保信息在整个架构中不被丢失。
- 归一化(Layer Normalization):类似于 批量归一化(Batch Normalization),有助于加速训练过程。
3.输出层
- 线性层与 Softmax 层:解码器的输出会通过一个 线性层,然后是 Softmax 层,最终生成下一个单词的概率分布。
训练过程中的掩码多头注意力(Masked Multi-Head Attention)
- 训练与推理的区别:在训练过程中,我们有 完整的目标句子(例如从法语到英语的翻译),而在推理时,模型是 逐词生成 的。
- 掩码多头注意力:在训练时,模型只“看到”已经生成的部分,而掩码机制会隐藏后续的单词,模拟生成过程中“逐步预测”的过程。
Transformer 网络的进一步优化
- 除了位置编码和残差连接,Transformer 还使用了 BatchNorm 类似的层,称为 Add & Norm,帮助加速学习过程。
- 通过这些优化,Transformer 在处理语言翻译任务时表现出色,能够同时计算多个维度的信息,并有效捕捉句子的上下文关系。
总结与展望
- Transformer 网络 结合了 自注意力、多头注意力、位置编码、残差连接 等机制,使其在处理 序列到序列任务 时非常强大。
- 通过逐步学习如何生成翻译的每个词,您现在可以理解 Transformer 的基本工作原理。
- 在进一步探索中,您将会接触到更先进的模型,如 BERT 和 DistilBERT,它们在自然语言处理任务中具有重要的应用。
通过本周的编程练习,您将能够更深入地理解如何将 Transformer 网络应用到实际问题中,提升您的应用开发能力!