Module 01 · Recurrent Neural Networks
Recurrent Neural Network Model循环神经网络模型
在上一期视频中,我们介绍了定义序列学习问题所需的符号表示。现在,我们将探讨如何构建一个神经网络模型来学习从 x 到 y 的映射。
1.标准神经网络与序列问题的局限性
在解决这个任务时,您可能会考虑使用标准神经网络。例如,在之前的示例中,我们有 9 个输入词。您可以尝试将这 9 个词(可能是 9 个独热编码向量)输入到一个标准神经网络中,经过若干隐藏层后,输出 9 个值(0 或 1),表示每个单词是否是人物的名字。
然而,这种方法存在两个主要问题:
- 输入和输出长度不一致:不同的样本可能具有不同的输入长度 和输出长度 ,如果每个句子的最大长度不同,你可能需要对每个输入进行填充(zero-padding),但这并不是最理想的表示方法。
- 缺乏共享特征:在标准神经网络中,不同位置的特征没有共享。例如,如果神经网络学到“Harry”在句子中的第一个位置提示它是一个人名,那么它无法自动识别其他位置的“Harry”也可能是人名。换句话说,神经网络无法像卷积神经网络(CNN)那样跨位置共享学习到的特征。
- 独热编码的局限性 🚧
例如,之前我们提到,每个输入词可能是一个 10,000 维的独热向量(one-hot vector)。如果句子中有 个单词,那么输入层的大小就是:
这种表示方式虽然简单直观,但问题在于:- 输入层非常庞大:每个词都是一个 10,000 维的向量,这就意味着如果有大量的词汇和句子长度较长,输入层会非常庞大。
- 权重矩阵参数过多:第一层的权重矩阵将会包含 10,000 × 10,000 个参数,导致模型的计算量和存储需求都非常高。
2.递归神经网络(RNN)简介
2.1RNN的基本原理
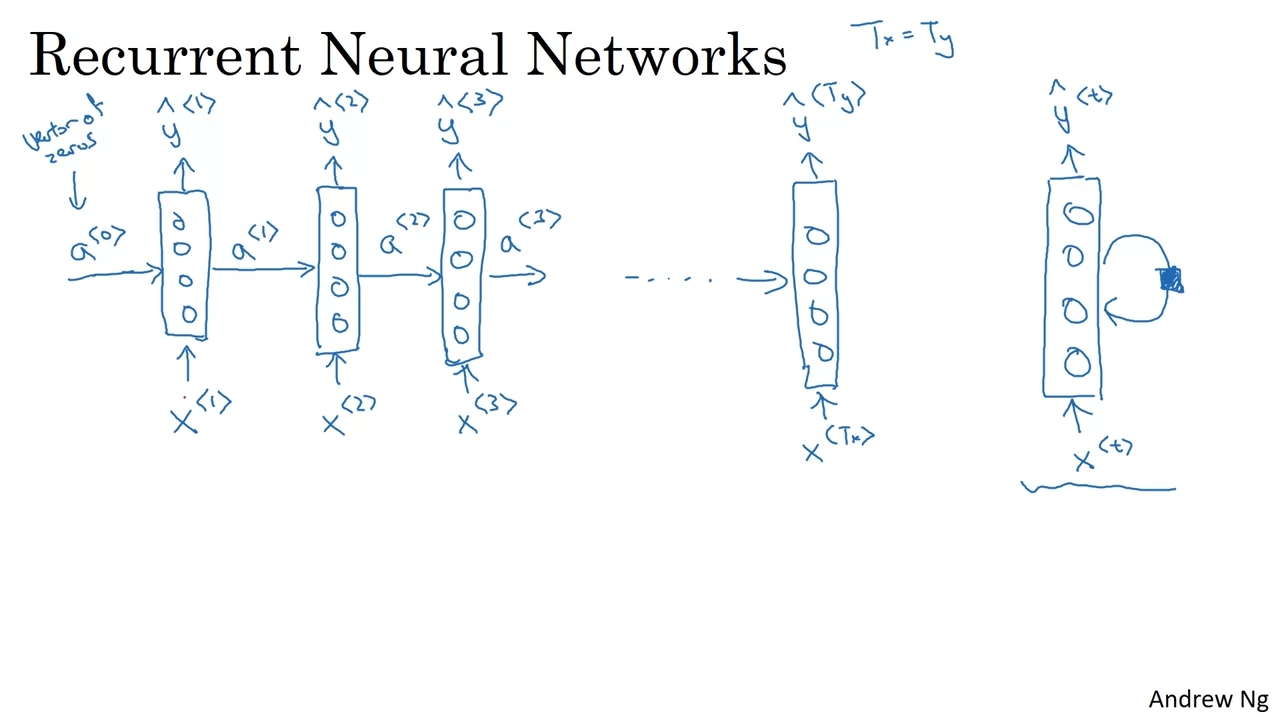
递归神经网络(RNN)能够克服这些问题,它可以通过循环机制处理序列数据。我们从左到右读取句子时:
- 第一个词:例如 ,将其输入到神经网络中,神经网络产生第一个预测 。
- 第二个词:例如 ,除了输入 ,它还会将来自第一个时刻的激活值传递给第二个时刻,使得第二个时刻不仅依赖于当前词 ,还依赖于前一时刻的上下文信息。
这个过程一直持续到最后一个词 ,每个时刻都会生成对应的预测 。
2.2递归机制
在递归神经网络中,每个时刻的输出 受到当前输入 以及之前时刻(如 t-1)激活值的影响。这种信息的“传递”使得神经网络能够捕捉序列中的长期依赖关系。
2.3初始化与激活
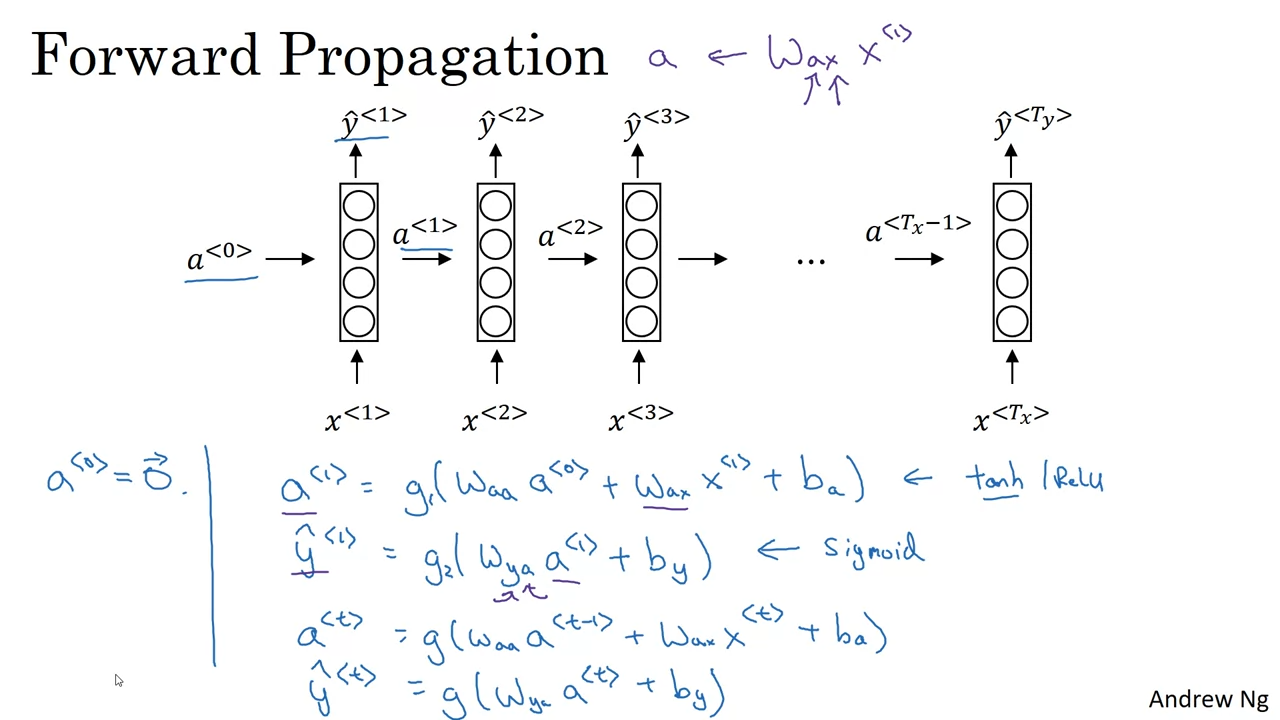
- 时间零的初始化:为了开始计算,RNN 会使用一个虚拟的初始化激活值 ,通常设为全零向量(有些研究会随机初始化 ,但通常使用零向量最为常见)。
- 递归过程:每个时刻的输出由以下公式计算:
- 激活值:
- 预测输出:
3.RNN的参数共享
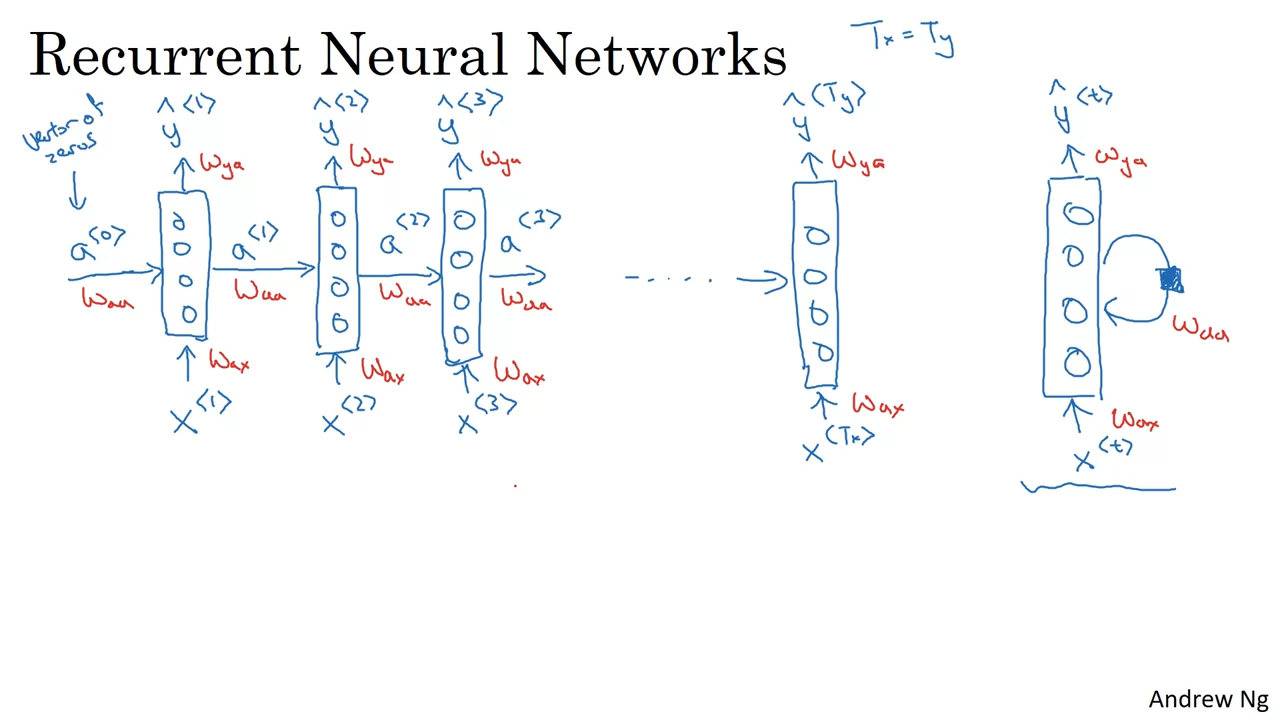
在递归神经网络中,所有时间步的参数是共享的,也就是说,对于每个时刻 t,我们使用相同的权重矩阵来计算激活值和预测输出。这些共享的参数包括:
- 输入到隐藏层的权重矩阵
- 隐藏层到隐藏层的权重矩阵
- 隐藏层到输出层的权重矩阵
3.1权重矩阵的结构
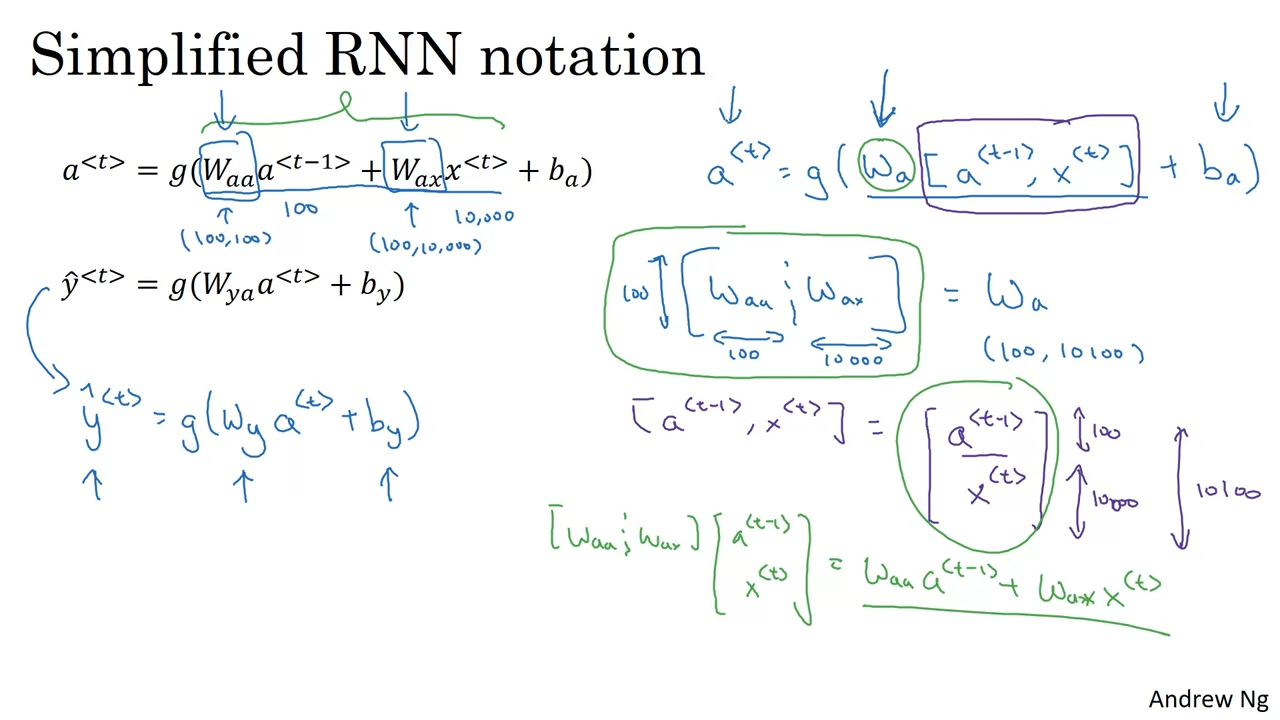
为了简化计算,RNN 可以将多个矩阵合并成一个矩阵。例如,将 和 水平堆叠在一起,形成一个新的权重矩阵 ,这样可以减少需要管理的参数数量。
4.RNN的局限性与挑战
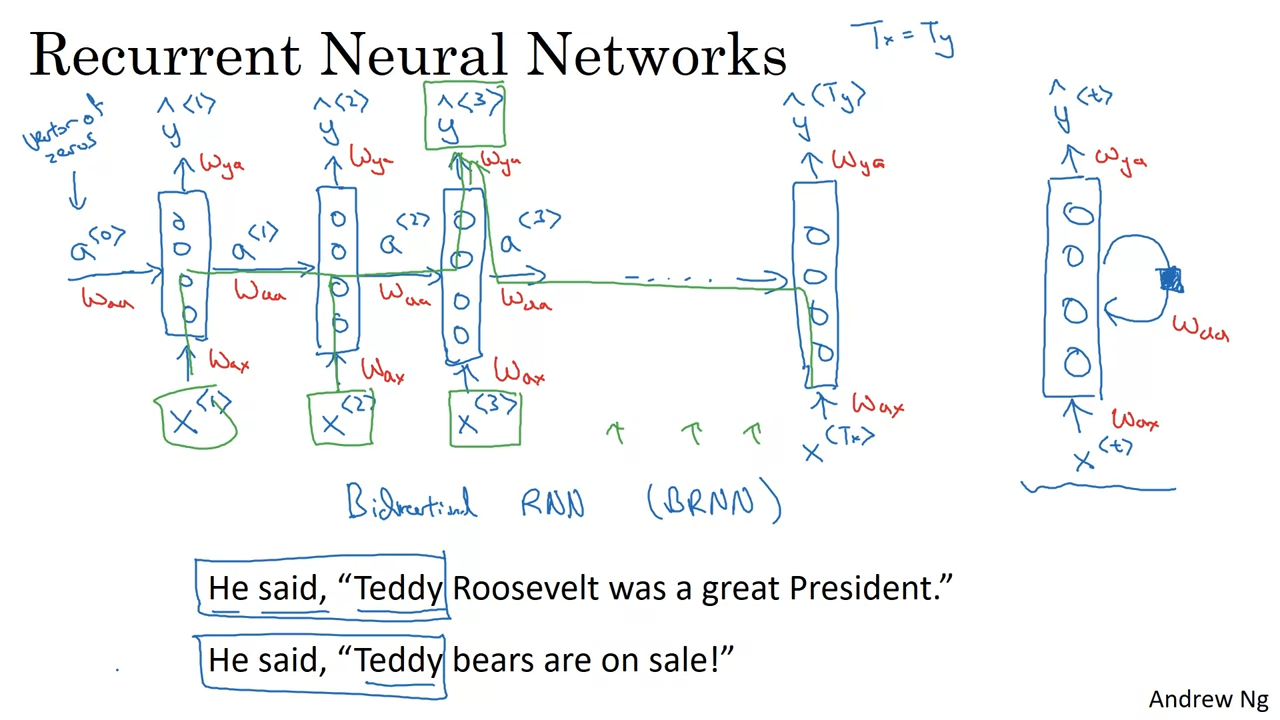
尽管 RNN 很强大,但它也有一个局限性:它只能利用前面的信息来做出当前的预测。例如,当预测 时,RNN 只能使用 和 提供的信息,而无法利用后续单词(如 )的信息。
举个例子,在句子“He said Teddy Roosevelt was a great president”中,判断“Teddy”是否是人名时,单纯依赖前面几个词的信息是不够的。我们需要后续的“Roosevelt”信息来判断是否是人名。
为了克服这个问题,**双向递归神经网络(BRNN)**可以被引入,后续会讲解如何使用双向RNN来同时利用句子前后文的信息。
5.前向传播与公式推导
5.1前向传播的步骤
-
初始化:我们从 开始。
-
计算输出预测:根据激活值计算预测输出 :
其中,g 通常是一个非线性激活函数,例如 tanh 或 sigmoid。
5.2简化后的表示法
为了简化表示,我们将合并权重矩阵 和 为一个矩阵 ,从而简化公式为:
这样, 就是一个由 和 拼接而成的矩阵。
总结
在本视频中,我们介绍了递归神经网络(RNN)的基本概念和构建方法。RNN 是解决序列学习任务(如命名实体识别)的一种强大工具,它能够通过共享参数和信息传递机制,捕捉序列中的上下文关系。
接下来,我们将探讨如何使用 反向传播算法 来训练这些 RNN 模型,并优化其参数。