Module 01 · Recurrent Neural Networks
Gated Recurrent Unit (GRU)门控循环单元
在之前的学习中,我们了解了 基本 RNN 的工作原理。在这一部分视频中,我们将深入探讨 GRU(门控循环单元),它对 RNN 隐藏层进行了一些修改,从而在捕捉长距离依赖和解决 梯度消失问题 上表现得更为优秀。接下来,让我们一起看看 GRU 是如何工作的。 🚀
1. GRU 的背景与动机
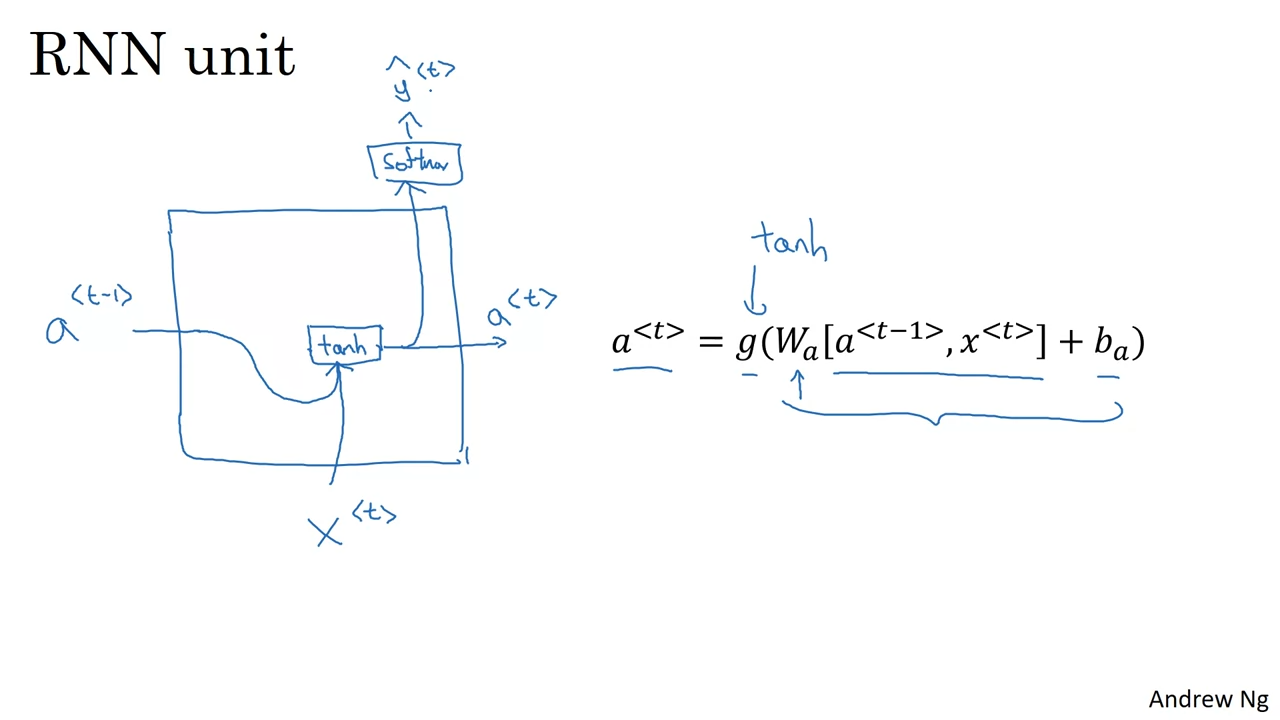
你可能已经看到过用于计算 RNN 激活值的公式,形式如下:
在这里, 表示上一时刻的激活值, 是当前输入, 是参数矩阵, 是偏置项。
接下来,我们将通过图示来帮助理解 RNN 的运作。RNN 单元的图示如下:
- 输入:(上一个时刻的激活值)和 (当前输入)
- 输出:经过加权和偏置计算后,经过激活函数(如 tanh)计算的输出激活值
这个图示是我们理解 GRU 的基础图形。
2. GRU 的核心思想与创新
2.1 GRU 单元的结构
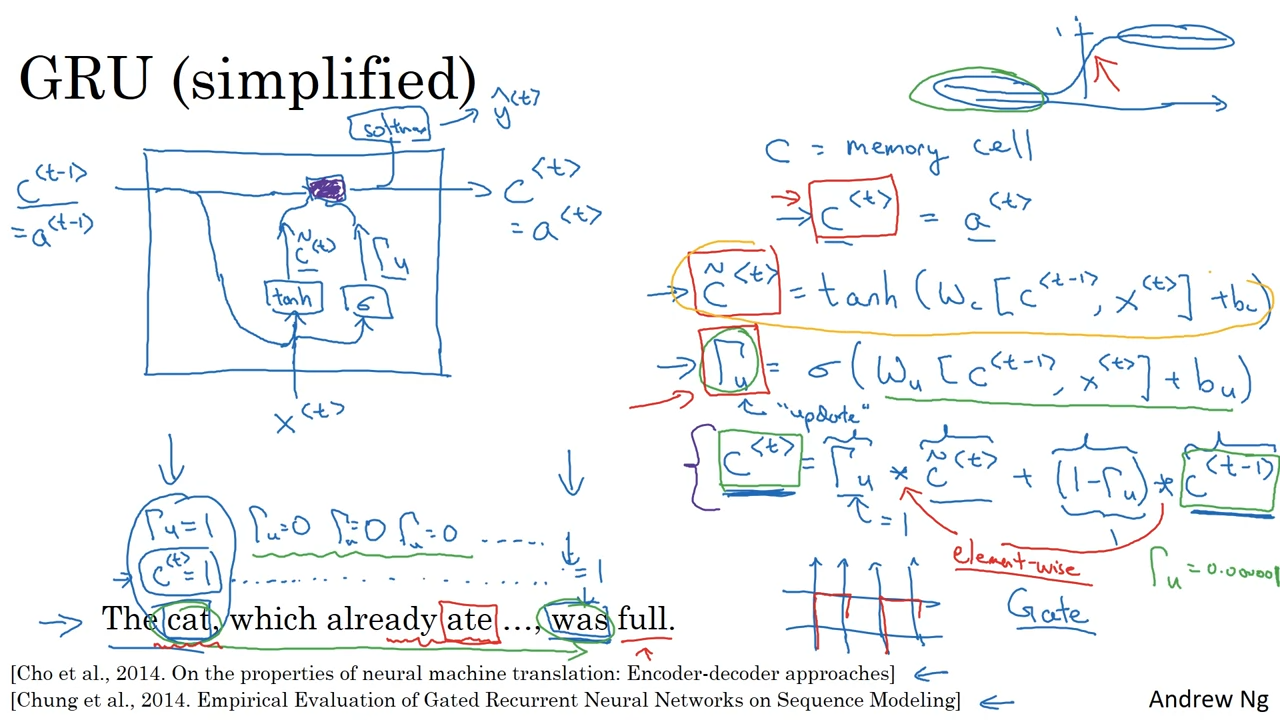
GRU 单元的创新在于引入了一个新的变量——C(Memory Cell)记忆单元,它可以帮助记住一些关键信息,例如 “the cat” 是单数,从而确保我们在后续生成文本时能够正确使用 "was" 或 "were"。
- 在每个时刻 t,记忆单元会有一个值 。
- GRU 会输出一个激活值 ,此时 。
重要提示:在 GRU 中,记忆单元和输出激活值是相同的()。但在后续介绍的 LSTM 中,这两个值会有所不同。
2.2 GRU 的核心公式与结构
在 GRU 中,每个时刻都会计算一个候选值 ,用于更新记忆单元。候选值计算公式如下:
接下来,GRU 引入了一个 更新门(Update Gate),记作 ,它决定是否更新记忆单元。更新门的值是介于 0 和 1 之间的,通过 sigmoid 激活函数计算。
2.3 更新门的作用
- 当 时,更新记忆单元:
- 当 时,记忆单元保持不变:
2.4 记忆单元的更新公式
2.5 更新门的直觉
想象一下,我们在扫描句子时,遇到 "the cat" 这样的短语。此时,更新门 将会被设为 1,更新记忆单元 ,以便捕捉 "cat" 作为 单数 的信息,直到句子后续部分需要使用到该信息为止。
- 如果 ,则不会更新记忆单元,保持原值,直到真正需要时才进行更新。
3. GRU 的图示与可视化
下面是 GRU 单元的简化图示,帮助理解其内部工作原理:
- 输入:(上一个时刻的激活值)和 (当前输入)
- 候选值计算:通过加权求和、tanh 激活计算得到候选值
- 更新门:通过 sigmoid 激活函数计算 ,确定是否更新记忆单元
- 记忆单元更新:根据 的值决定记忆单元的更新方式
最终,GRU 会输出记忆单元的值,作为激活值 ,并可以通过 Softmax 层预测输出值 。
4. GRU 如何解决梯度消失问题?
由于 GRU 的 更新门 可以非常灵活地控制记忆单元的更新,它能够有效避免 梯度消失问题。当 逼近 0 时,记忆单元的值不会发生变化,从而使得 梯度能够在较长的序列中保持,解决了梯度消失的问题。
- 当 远离 0 时,记忆单元的值更新,可以捕捉到序列中较远位置的相关信息。
- 当 接近 0 时,记忆单元保持不变,有效避免了梯度消失。
5. GRU 的实际应用
5.1 参数维度与计算
- 记忆单元的维度:通常,记忆单元 是一个向量,维度与隐藏层的激活值相同(例如 100 维)。
- 元素级乘法:在计算过程中,使用元素级乘法来控制哪些部分需要更新。
5.2 比较与 LSTM
GRU 和 LSTM(长短期记忆网络) 都是为了解决 长距离依赖 和 梯度消失 问题而设计的。GRU 在计算上更简洁,但 LSTM 引入了更多的门控机制,可能在一些复杂的任务中表现更好。
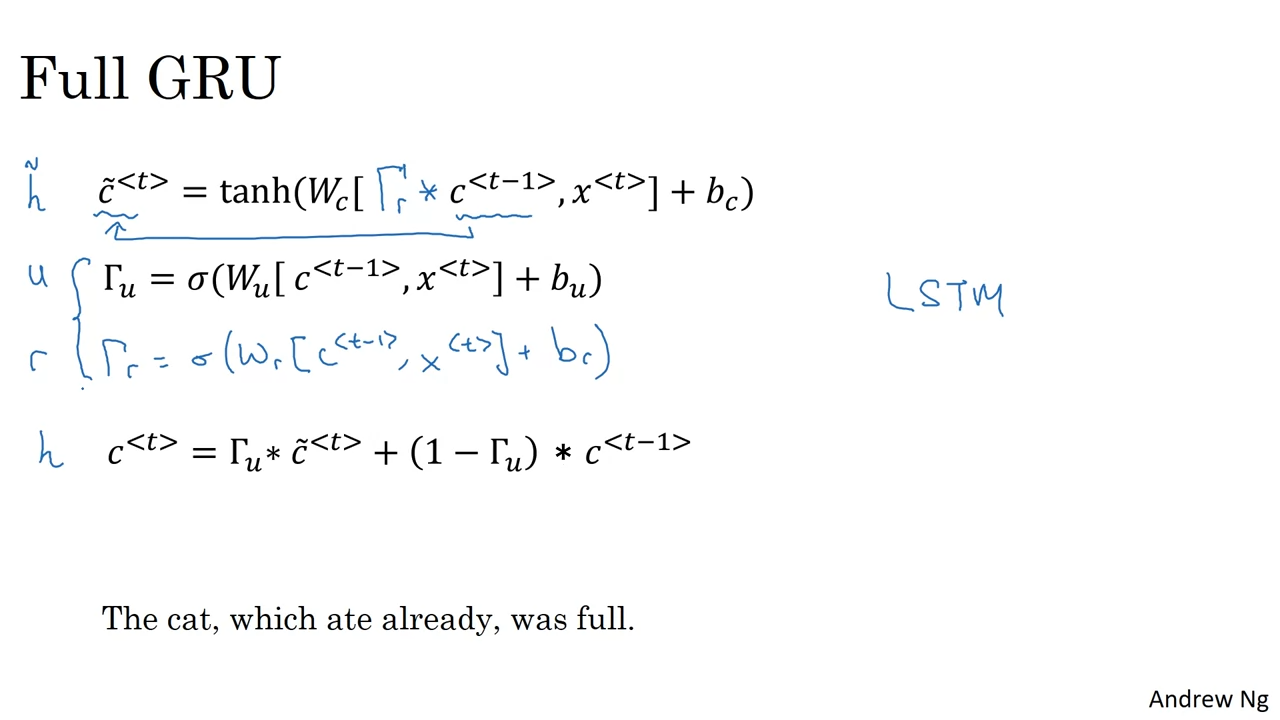
小结
| 关键点 | 基本 RNN | GRU(门控循环单元) |
|---|---|---|
| 梯度消失问题 | 存在问题,难以捕捉长距离依赖 | 通过更新门有效避免梯度消失 |
| 记忆单元 | 无记忆单元,只依赖当前输入和上一时刻的输出 | 引入记忆单元 ,可存储长期信息 |
| 更新机制 | 直接使用上一时刻的激活值 | 使用更新门 控制记忆单元的更新 |
| 常见应用 | 适用于短序列数据,性能有限 | 适用于长序列数据,能够捕捉长距离依赖 |
未来展望:LSTM 与 GRU 的选择
GRU 是为了解决 RNN 在长序列学习中的问题而设计的,它通过 门控机制 提供了更强的记忆能力,避免了梯度消失问题。而 LSTM(长短期记忆网络)也是解决同样问题的另一个常用方法。
在下一节视频中,我们将详细探讨 LSTM 的原理,了解它与 GRU 的区别和优缺点。🎥